Irrelevante Google-Ergebnisse tauchten über Nacht bei mehr als 57 % der Keywords auf
Seit September 2026 beobachten SEO-Teams und Rank-Tracking-Anbieter etwas Seltsames in den Ranking-Daten von Google. Websites verschwinden auf einmal aus den Ergebnissen, an ihrer Stelle tauchen Seiten auf, die dort vorher nie zu sehen waren. Die Ranking-Abfrage selbst läuft ohne erkennbaren Fehler durch, doch die Ergebnisse, die Google zurückliefert, passen nicht zur Suche.
Möglicherweise hängt das mit einem Problem zusammen, das Google lösen will, und zwar mit Bots, die Suchergebnisse massenhaft auslesen. Wie Google in seinen Richtlinien erklärt, verbrauchen automatisierte Anfragen Ressourcen und können es Google erschweren, seine Nutzer zu bedienen.
Manche in der SEO-Community vermuten, dass Google gezielt KI-Scraping stören will und Rank-Tracker, die Ergebnisse ebenfalls automatisiert abrufen, dabei in dieselben Filter geraten.
Unser Team bei SE Ranking reagiert seit dem ersten Tag aktiv auf diese Veränderungen.
Hinweis: Aktuelle Updates findest du auf unserer Statusseite. Wenn dir Auffälligkeiten in deinen Ranking-Daten begegnen, schreib unserem Support an [email protected]. Nenn dabei den Projektnamen und ein paar Beispiel-Keywords, damit wir der Sache nachgehen können.
Parallel dazu wollten wir verstehen, wie verbreitet diese irrelevanten Ergebnisse sind und welchen Mustern sie folgen. Dafür haben wir 10.000 Keywords aus unserem Recherche-Index untersucht, einem Keyword-Set, das wir eigens für Studien pflegen und das von Kundenprojekten und Konten getrennt ist.
Analysiert haben wir die Desktop-Ergebnisse von Google USA aus September und Oktober 2026. Uns interessierte, wie oft Einträge auftauchten, die nicht zur Suchanfrage passten, was sie zeigten und an welcher Position sie begannen.
Das haben wir herausgefunden.
-
Irrelevante Google-Ergebnisse betrafen über Nacht 57,3 % der Keywords, nach 0,09 % am Vortag.
Der Sprung erfolgte am 17. September in unserer Stichprobe von 10.000 Keywords.
-
Bis zum 24. September stieg der Anteil betroffener Keywords auf 67,2 %.
Das war der höchste Wert im gesamten Untersuchungszeitraum.
-
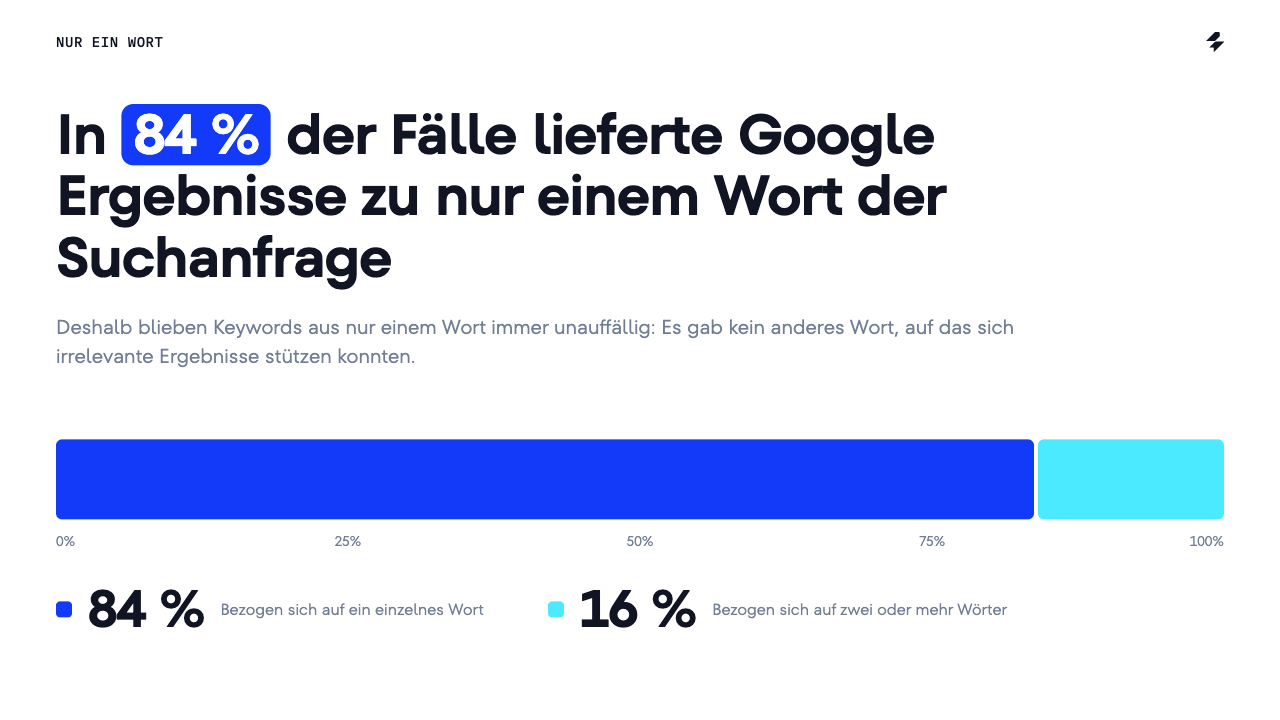
In 84 % der Fälle lieferte Google Ergebnisse zu nur einem Wort der Suchanfrage.
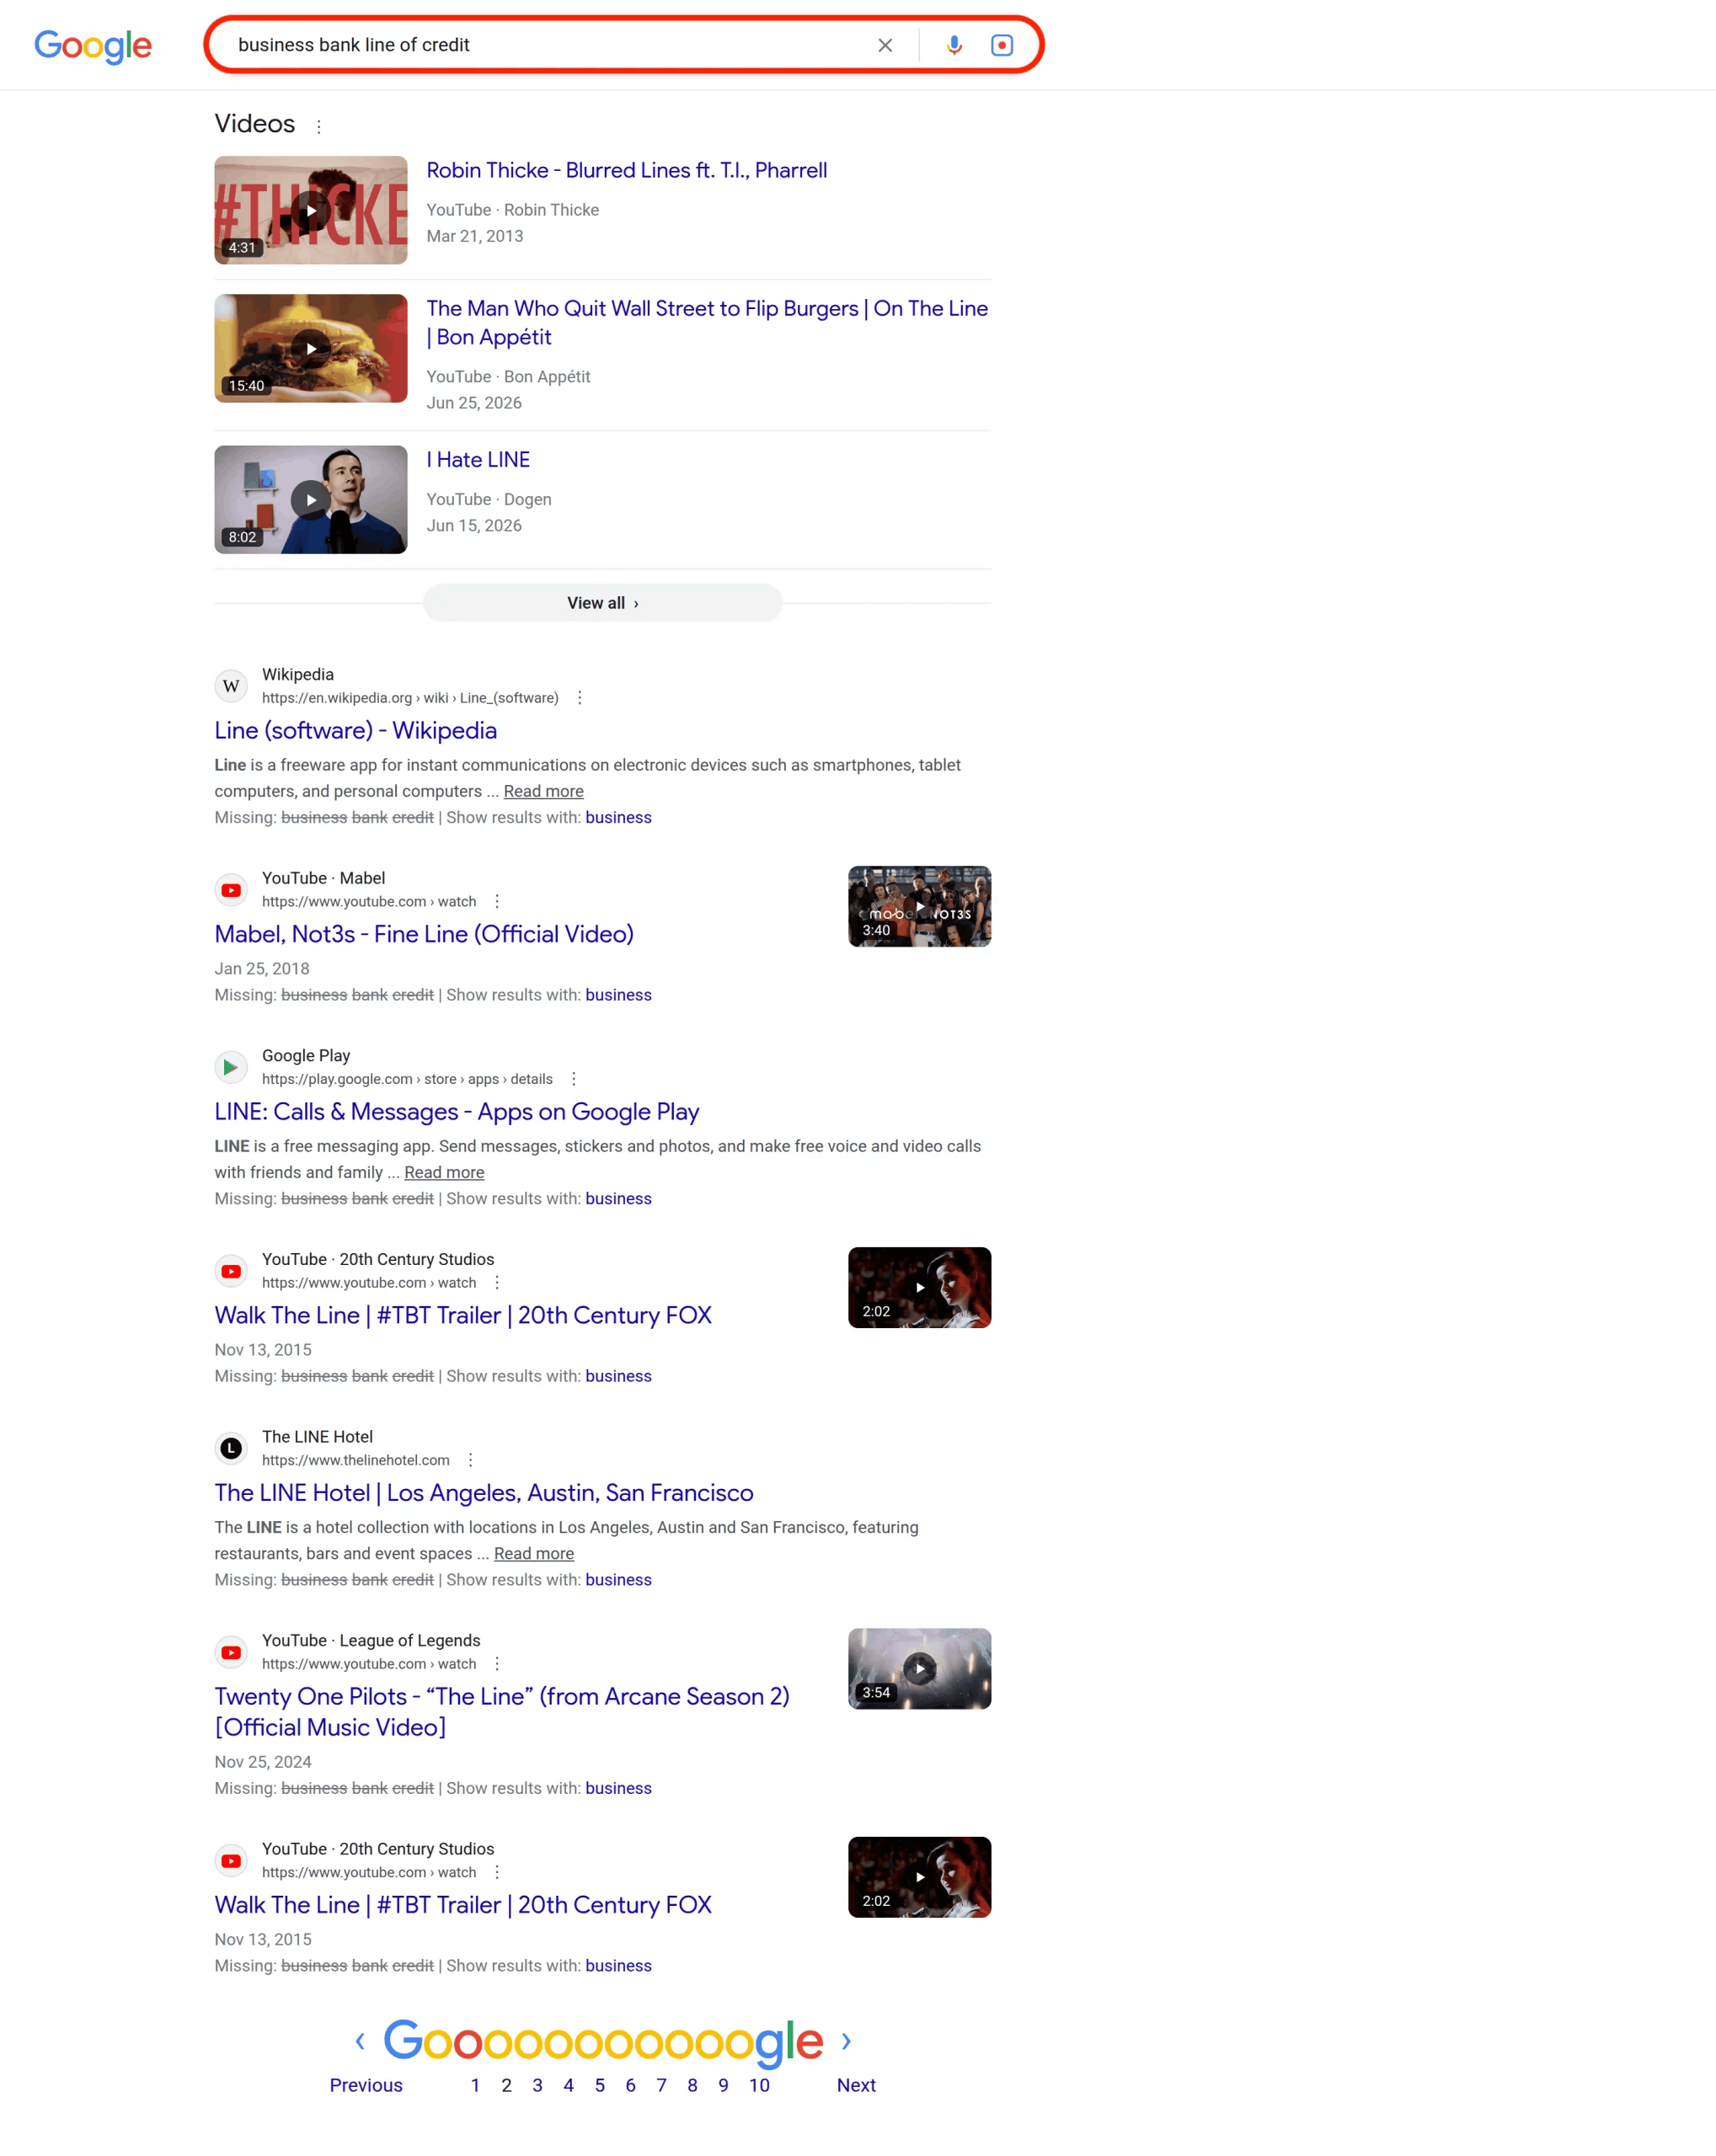
Bei der Suche „business bank line of credit“ (Kreditlinie für Unternehmen) drehten sich die Treffer zum Beispiel um das Wort „line“: die Messenger-App Line, The Line Hotel und Florida Georgia Line statt Informationen zur Unternehmensfinanzierung.
-
Irrelevante Google-Ergebnisse begannen fast immer außerhalb der Top 8.
96,5 % der Blöcke mit irrelevanten Ergebnissen starteten auf Position 9 oder tiefer, 3,5 % auf Position 6 bis 8 und keiner in den Top 5.
Was sind irrelevante SERPs?
Irrelevante SERPs, in der deutschen SEO-Szene meist „vergiftete SERPs“ oder „Poisoned SERPs“ genannt, sind Suchergebnisseiten, die Google auf automatisierte Abfragen ausliefert. Sie wirken gültig, enthalten aber irreführende Ergebnisse.
Ein Beispiel aus unserer Studie ist die Suchanfrage „business bank line of credit“ (Kreditlinie für Unternehmen). Die ersten neun Ergebnisse zeigten erwartungsgemäß Banken und Kreditgeber wie Chase, US Bank, PNC und LendingTree.
Auf Seite 2 ging es dagegen gar nicht mehr um Unternehmenskredite. Dort tauchten Musikvideos, die Messenger-App LINE und The LINE Hotel auf. Mit der Suchanfrage teilten diese Ergebnisse zwar das Wort „line“, beantwortet hat sie aber keines davon. In unseren Referenzabfragen erschien für dieselbe Suche auch keines dieser Ergebnisse.
Aus Sicht eines Rank-Trackers scheint die Abfrage funktioniert zu haben, denn Google hat eine gültig wirkende Ergebnisseite geliefert.
Fehlt eine Website jedoch in diesen Einträgen, verzeichnet das Tool womöglich einen Ranking-Verlust, obwohl sich die tatsächliche Position nicht verändert hat. Eine Fehlermeldung, die darauf hinweist, gibt es nicht. Das Problem zeigt sich erst, wenn du dir ansiehst, worum es in den Ergebnissen eigentlich geht.
Was die SEO-Community beobachtet hat
Anfang Oktober äußerten immer mehr SEO-Profis Zweifel an Ranking-Daten, die nicht zu dem passten, was sie selbst in Google sahen. Barry Schwartz hat viele dieser Beobachtungen in seinem Beitrag auf Search Engine Roundtable zusammengetragen, darunter die folgenden Kommentare.
Am 9. Oktober beschrieb Lily Ray, wie die Unsicherheit sie davon abhielt, ihre Analyse zu teilen.
Am selben Tag erklärte Alex Wolk, dass er Suchanfragen manuell in einem Inkognito-Fenster prüft, bevor er den Bewegungen traut, die Tracking-Tools melden.
Andere diskutierten, woran die Abweichungen liegen könnten.
Antony Deroshan etwa vermutete, dass Google automatisierten Traffic erkennt und Junk-Ergebnisse ausliefert, statt die Anfragen direkt zu blockieren. Das war seine Interpretation, keine von Google bestätigte Erklärung.
Am 10. Oktober fasste Marty Eigner seine Erfahrung noch knapper zusammen.
Auch in der deutschsprachigen SEO-Szene war das Thema präsent. onlinemarketing.de berichtete am 20. Oktober ausführlich darüber.
Diese Beobachtungen machten auf das Problem aufmerksam. Untersuchungen der Anbieter lieferten anschließend die Zahlen dazu.
- Nozzle (21. Oktober) stufte in seiner Studie 22,6 % der seit dem 13. September untersuchten SERPs als „vergiftet“ ein, mit einem Tageshöchstwert von 43,5 % am 30. September. Nach Zielland aufgeschlüsselt lag Österreich mit 21,0 % auf Platz 2 von 45 Ländern, die Schweiz mit 16,1 % auf Platz 5 und Deutschland mit 6,4 % auf Platz 36.
- Keyword.com (1. November) stufte in seiner Analyse 13,1 % der SERPs vom 13. September bis 14. Oktober als „vergiftet“ ein, verglichen mit 0,3 % im August. Für google.de kam die Analyse ebenfalls auf 13,1 %.
Die Zahlen gehen auseinander, weil jeder Anbieter andere Keywords, Zeiträume und Erhebungsmethoden betrachtet hat. Sie deuten aber auf dasselbe Problem hin: Google lieferte mehreren Anbietern unzuverlässige Ergebnisse.
Warum könnte Google diese Ergebnisse ausliefern?
Eine Theorie von Derek Perkins von Nozzle lautet, dass Google KI-Scraping stören will, indem es irreführende Ergebnisse ausliefert, statt automatisierte Anfragen direkt zu blockieren. Da Rank-Tracker Ergebnisse ebenfalls automatisiert abrufen, könnten sie in dieselben Filter geraten.
Ricardo Batista von Cloro liefert eine verwandte Erklärung. Seiner Ansicht nach leitet Google einen Teil des automatisierten Traffics offenbar auf einen minderwertigeren Ergebnissatz um. Plausible, aber falsche Antworten seien für Scraper schwerer zu erkennen als eine offene Blockade.
Hinweis: Bestätigt sind diese Erklärungen nicht. Google hat sich öffentlich nicht zu den irreführenden Ergebnissen geäußert.
Wie sich das Problem bei 10.000 Google-Suchen zeigte
Wir haben 10.000 Keywords in Google USA (Desktop) untersucht und pro Keyword bis zu 50 organische Ergebnisse gespeichert. Die Daten aus dem September decken den 14. bis 24. September ab, dazu kommen vier weitere Abfragen am 14. und 15. Oktober.
Im achttägigen Testzeitraum vom 17. bis 24. September ergab das 80.000 Fälle, wobei ein an einem Tag geprüftes Keyword als ein Fall zählt. Die Ergebnisse haben wir in mehreren Schritten validiert, unter anderem durch manuelle Prüfung strittiger Fälle.
Wie wir die Daten erhoben und validiert haben, liest du im Abschnitt zur Methodik.
Irrelevante Google-Ergebnisse sprangen über Nacht von 0,09 % auf 57,3 %
In den ersten drei Tagen lag der geschätzte Anteil betroffener Keywords unter 0,1 %. Dann änderte sich das Bild schlagartig. Am 16. September waren es 0,09 %, am 17. September schon 57,3 %.
Bis zum 23. September blieb der Wert zwischen 56,9 % und 60,2 %.
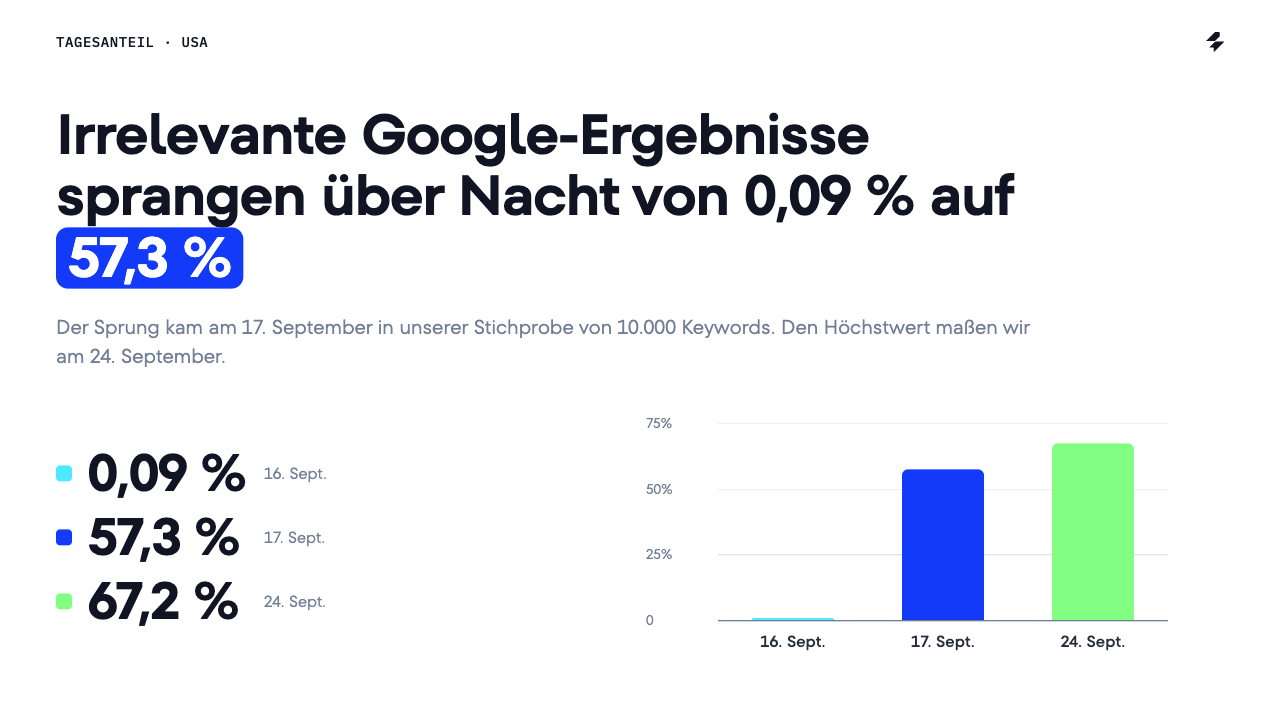
Um einen einzelnen Ausreißer handelte es sich nicht, denn das Muster zog sich durch alle acht Testtage. Den höchsten Wert maßen wir am 24. September, als 67,2 % der Keywords in unserer Stichprobe irrelevante Ergebnisse lieferten.
In 84 % der Fälle passten die Ergebnisse zu einem einzigen Wort statt zur ganzen Suche
Die Einträge, die nicht zur Suchanfrage passten, hatten oft etwas gemeinsam. Sie drehten sich um ein einzelnes Wort aus der Suchanfrage. Der Rest der Phrase und damit das, was die Person eigentlich finden wollte, ging offenbar verloren.
Die Suche „business bank line of credit“ sollte zum Beispiel Informationen zur Unternehmensfinanzierung liefern. Stattdessen enthielt ein Teil der Ergebnisse die Messenger-App Line, The Line Hotel, die High Line und die Band Florida Georgia Line. Alle hatten mit „line“ zu tun, doch keines beantwortete die vollständige Suche.
Dasselbe sahen wir bei anderen Suchanfragen:
Bezugswort der irrelevanten Ergebnisse
line
Beispiele für gelieferte Ergebnisse
Messenger-App Line, The Line Hotel, die High Line, Florida Georgia Line
Bezugswort der irrelevanten Ergebnisse
into
Beispiele für gelieferte Ergebnisse
intostudy.com, into.org, intoglobal.com, into-tampere.org
Bezugswort der irrelevanten Ergebnisse
own
Beispiele für gelieferte Ergebnisse
Oprahs Sender OWN, „In Their Own Words“, Podcast „Mind Your Own“
Bezugswort der irrelevanten Ergebnisse
pot
Beispiele für gelieferte Ergebnisse
The Melting Pot, Lobster-Pot-Restaurants, Petit Pot, Dogipot
Bezugswort der irrelevanten Ergebnisse
dry
Beispiele für gelieferte Ergebnisse
Dry January, Vorschriften für chemische Reinigungen (Dry Cleaner), Dry Creek Vineyard, trocken geröstete Erdnüsse
line
Messenger-App Line, The Line Hotel, die High Line, Florida Georgia Line
into
intostudy.com, into.org, intoglobal.com, into-tampere.org
own
Oprahs Sender OWN, „In Their Own Words“, Podcast „Mind Your Own“
pot
The Melting Pot, Lobster-Pot-Restaurants, Petit Pot, Dogipot
dry
Dry January, Vorschriften für chemische Reinigungen (Dry Cleaner), Dry Creek Vineyard, trocken geröstete Erdnüsse
In 84 % der Fälle bezogen sich die irrelevanten Einträge auf ein Wort der ursprünglichen Suche. In den übrigen 16 % bezogen sich aufeinanderfolgende Ergebnisgruppen auf zwei oder mehr Wörter.
Ergebnisse zu einem Wort der Suchanfrage teilen deren Vokabular und oft auch den Website-Typ. Selbst die Kosinus-Ähnlichkeit, ein Maß dafür, wie ähnlich sich zwei Texte inhaltlich sind, liegt bei diesen Seiten deutlich über null.
Eine automatisierte Prüfung könnte also durchaus eine gewisse Ähnlichkeit erkennen, weil die Ergebnisse zu einem Teil der Suche passen, auch wenn sie nicht beantworten, was die Person tatsächlich gesucht hat.
Das könnte erklären, warum Keywords aus nur einem Wort in unserem Datensatz immer unauffällig blieben. Bei einem einzigen Wort gab es schlicht kein anderes Wort, auf das sich irrelevante Ergebnisse hätten stützen können.
Die ersten fünf Ergebnisse können völlig normal aussehen
Die irrelevanten Einträge begannen nicht immer ganz oben. Eine Seite konnte mit relevanten Ergebnissen starten und dann mittendrin umschlagen.
In unserer Stichprobe begannen die irrelevanten Ergebnisse in 3,5 % der betroffenen Ergebnislisten auf Position 6 bis 8. In den übrigen 96,5 % der Fälle kam der Wechsel weiter unten, also auf Position 9 oder tiefer.
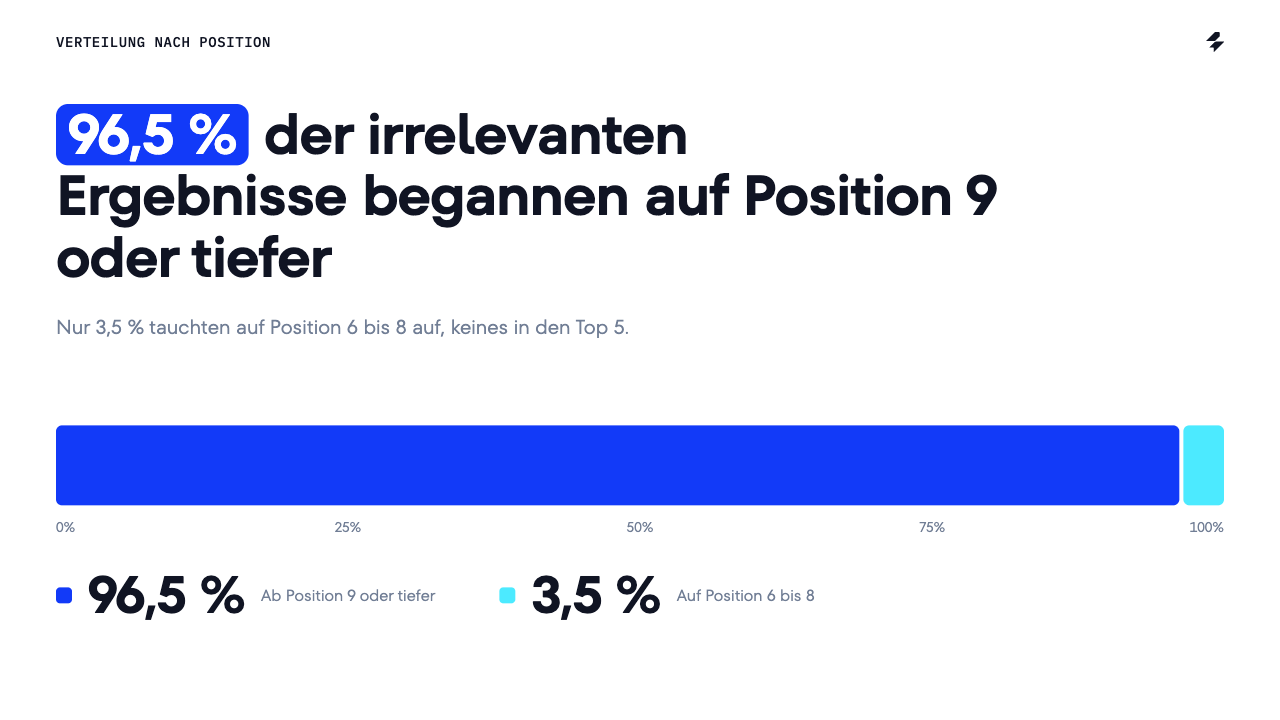
Ein kurzer Blick auf die Top-Ergebnisse kann also täuschen. Scrollst du weiter nach unten, hat die SERP womöglich kaum noch etwas mit der Suchanfrage zu tun.
Rankt eine Website normalerweise in diesem Bereich, können irrelevante Seiten in den erhobenen Ergebnissen ihren Platz einnehmen. Das Tool meldet die Website dann womöglich als fehlend oder mit Positionsverlusten, obwohl sich ihr Ranking für Menschen, die bei Google suchen, nicht unbedingt verändert hat.
Facebook tauchte in 45,2 % der irrelevanten Google-Ergebnisse auf, gefolgt von Reddit und Instagram
Die Ergebnisse, die nicht zur Suchanfrage passten, stammten oft von großen Plattformen. Facebook erschien in 45,2 % der markierten Fälle, Reddit in 41,3 % und Instagram in 31,6 %.
Die Liste ging aber weit über soziale Netzwerke hinaus. Auch Nachrichtenseiten, Wörterbücher, App-Stores und Forschungsdatenbanken waren dabei.
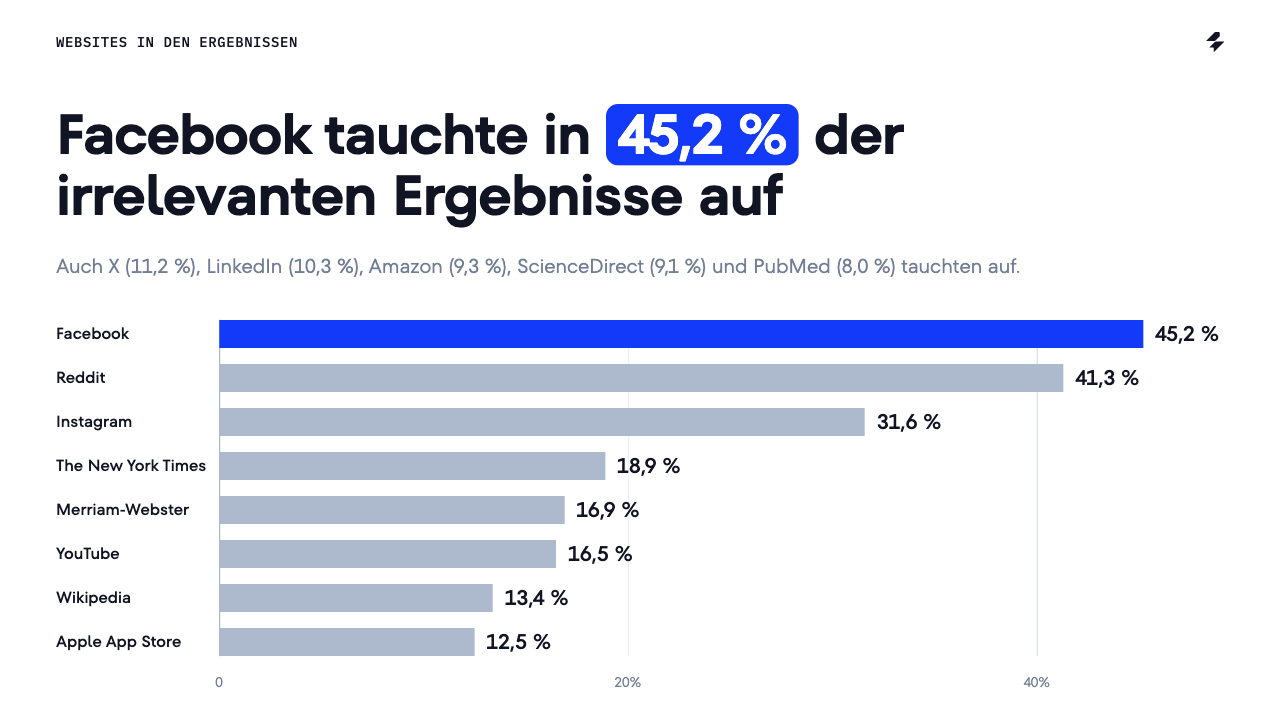
Besonders aufschlussreich ist Merriam-Webster. Das Wörterbuch tauchte in etwa jedem sechsten markierten Fall auf, jeweils mit der Definition des Wortes, um das sich die irrelevanten Ergebnisse drehten. Die Definition selbst konnte korrekt sein und trotzdem wenig mit dem zu tun haben, wonach die Person gesucht hatte.
Dasselbe gilt für die anderen Websites in der Liste. Ein Wörterbucheintrag, ein Facebook-Post oder ein Nachrichtenartikel kann für sich genommen glaubwürdig wirken. Um das Problem zu erkennen, musst du prüfen, ob er die vollständige Suchanfrage beantwortet.
Was du tun kannst, wenn ein Ranking falsch wirkt
Wirkt eine Position unerwartet, starte zuerst eine erneute Abfrage. Bevor du von einem bestätigten Ranking-Verlust ausgehst, vergleiche die Position kurz mit dem bisherigen Verlauf des Keywords.
- Achte auf das Muster. Ist ein einzelnes Keyword gefallen oder haben sich mehrere gleichzeitig verändert? Schau dir mehr als nur den Vortag an, um zu sehen, ob die Bewegung anhält.
- Prüfe ergänzende Daten. Sieh nach, ob sich Impressionen und Klicks in der Google Search Console für die betreffende Suchanfrage und Seite verändert haben. Berücksichtige dabei Unterschiede bei Datum, Land und Gerät. Ein einzelner Vergleich klärt die Ursache noch nicht.
Wenn du einen Kundenbericht vorbereitest, prüfe einen isolierten, plötzlichen Einbruch, bevor du ihn als Sichtbarkeitsverlust präsentierst. Gleichzeitig solltest du nicht jede unerwartete Veränderung für ein Datenproblem halten. Ein anhaltender Rückgang, den auch andere Signale stützen, verdient eine genauere SEO-Analyse.
Methodik der Studie
Wir haben 10.000 Keywords in Google USA (Desktop) analysiert und pro Keyword bis zu 50 organische Ergebnisse samt Position, URL und Domain erfasst. Die Daten decken den 14. bis 24. September ab, ergänzt um vier weitere Abfragen am 14. und 15. Oktober. Der Testzeitraum vom 17. bis 24. September umfasste 80.000 Keyword-Tag-Fälle.
Die Ergebnisse haben wir in drei Schritten geprüft:
- Referenz für jedes Keyword erstellt. Für jedes Keyword haben wir alle Ergebnisse gesammelt, die Google bei sieben Referenzabfragen außerhalb des betroffenen Zeitraums lieferte, drei davon im September und vier im Oktober. Zusammen bildeten sie die normalen Ergebnisse des Keywords. Jeden Testtag haben wir dann auf zwei Ebenen mit dieser Referenz verglichen. Auf Domain-Ebene galt eine Website als unbekannt, wenn sie an keinem Referenztag für das Keyword erschienen war. Das allein reichte nicht, denn viele irrelevante Seiten lagen auf Domains, die bei fast jeder Suchanfrage auftauchen, etwa Facebook, Reddit, YouTube und The New York Times. Eine reine Domain-Prüfung hätte sie als normal eingestuft. Bei Domains, die bereits in der Referenz vorkamen, haben wir deshalb zusätzlich geprüft, ob die konkrete Seite für dieses Keyword erschienen war. Ein Beispiel ist ein Facebook-Post über Deadpool („the fans got Deadpool off the ground so many years ago“), der für „how many calories do Americans eat on Thanksgiving“ (wie viele Kalorien Amerikaner an Thanksgiving essen) auftauchte. Die Domain facebook.com besteht die Domain-Prüfung, der Post fällt aber bei der Seitenprüfung durch, weil er nur über das Wort „many“ zur Suchanfrage passte.
- Auffällige Veränderungen von normaler Ranking-Bewegung getrennt. Eine Seite, die die Referenzprüfung nicht besteht, ist nicht automatisch irrelevant. Rankings verschieben sich, neue Seiten kommen hinzu, und auf hinteren Positionen gibt es mehr Bewegung als weiter oben. Deshalb haben wir für jeden Fall den Anteil der Ergebnisse berechnet, die auf einer der beiden Ebenen unbekannt waren, und den Fall ab einem Anteil von 50 % markiert. Fälle unterhalb dieser Schwelle haben wir ebenfalls geprüft, um kürzere Folgen irrelevanter Einträge zu erfassen.
- Ergebnisse validiert. Wir haben 750 Fälle mit unbekannten Ergebnissen sowie 150 Fälle von Referenztagen als Kontrollgruppe ausgewählt und deren Seitentitel und Beschreibungen geprüft. Zwei KI-Prüfer bewerteten jeden Fall unabhängig voneinander, ohne Datum oder Ergebnis des Algorithmus zu kennen. Bei abweichenden Urteilen haben wir 40 Fälle manuell geprüft und daraus eine Regel für Pattsituationen abgeleitet. Keiner der Kontrollfälle wurde als irrelevant bewertet. Die Tageswerte in diesem Artikel sind mit diesen Prüfergebnissen gewichtet. Sie berücksichtigen also sowohl Fehlalarme unter den markierten Fällen als auch irrelevante Ergebnisse, die der Algorithmus übersehen hat.
Grenzen der Studie: Diese Ergebnisse gelten für die hier untersuchte Stichprobe. Die Abfragen im Oktober liefen mit anderen Erhebungseinstellungen als im September. Wir haben ausschließlich organische Einträge untersucht, keine AI Overviews, Anzeigen oder anderen Suchfunktionen. Die Daten erlauben keine Aussagen über Googles Absichten, darüber, wie lange das Problem innerhalb eines Tages anhielt, oder darüber, was Menschen bei einer direkten Suche zu sehen bekamen. SE Ranking steht in keiner Verbindung zu Google.