Des résultats Google sans rapport avec le mot-clé apparaissent pour plus de 57 % des résultats
Depuis septembre 2026, les équipes SEO et les fournisseurs d’outils de suivi de positions constatent un phénomène étrange dans les données de classement Google. Des sites web disparaissent soudain des résultats, remplacés par des pages jamais vues jusque-là. La vérification des positions s’exécute sans erreur apparente, mais les résultats renvoyés par Google ne correspondent pas à la recherche.
L’origine pourrait être un problème que Google tente de résoudre : l’extraction massive de ses résultats de recherche par des bots. Comme l’expliquent ses règles, les requêtes automatisées consomment des ressources et peuvent nuire à sa capacité à servir les utilisateurs.
Une partie de la communauté SEO soupçonne Google de vouloir freiner spécifiquement le scraping par l’IA, et les outils de suivi de positions (qui collectent eux aussi les résultats de façon automatisée) seraient pris dans les mêmes filets.
Chez SE Ranking, notre équipe s’adapte activement à ces changements depuis le début.
Remarque : vous pouvez suivre les dernières mises à jour sur notre page de statut. Si vous constatez un problème dans vos données de classement, contactez notre équipe support à [email protected] en indiquant le nom du projet et quelques exemples de mots-clés pour que nous puissions enquêter.
En parallèle, nous avons voulu mesurer l’ampleur de ces résultats sans rapport et comprendre leur logique. Nous avons étudié 10 000 mots-clés de notre index de recherche (un ensemble de mots-clés réservé à la recherche, distinct des projets et des comptes clients).
Nous avons analysé leurs résultats sur Google aux États-Unis, sur desktop, collectés en septembre et octobre 2026, pour savoir à quelle fréquence des résultats sans rapport apparaissaient, ce qu’ils montraient et à partir de quelle position ils commençaient.
Voici ce que nous avons constaté.
-
Les résultats Google sans rapport avec la requête ont touché 57,3 % des mots-clés du jour au lendemain, contre 0,09 % la veille.
Le bond s’est produit le 17 septembre dans notre échantillon de 10 000 mots-clés.
-
Le 24 septembre, la part de mots-clés touchés a atteint 67,2 %.
C’est le taux le plus élevé observé pendant la période étudiée.
-
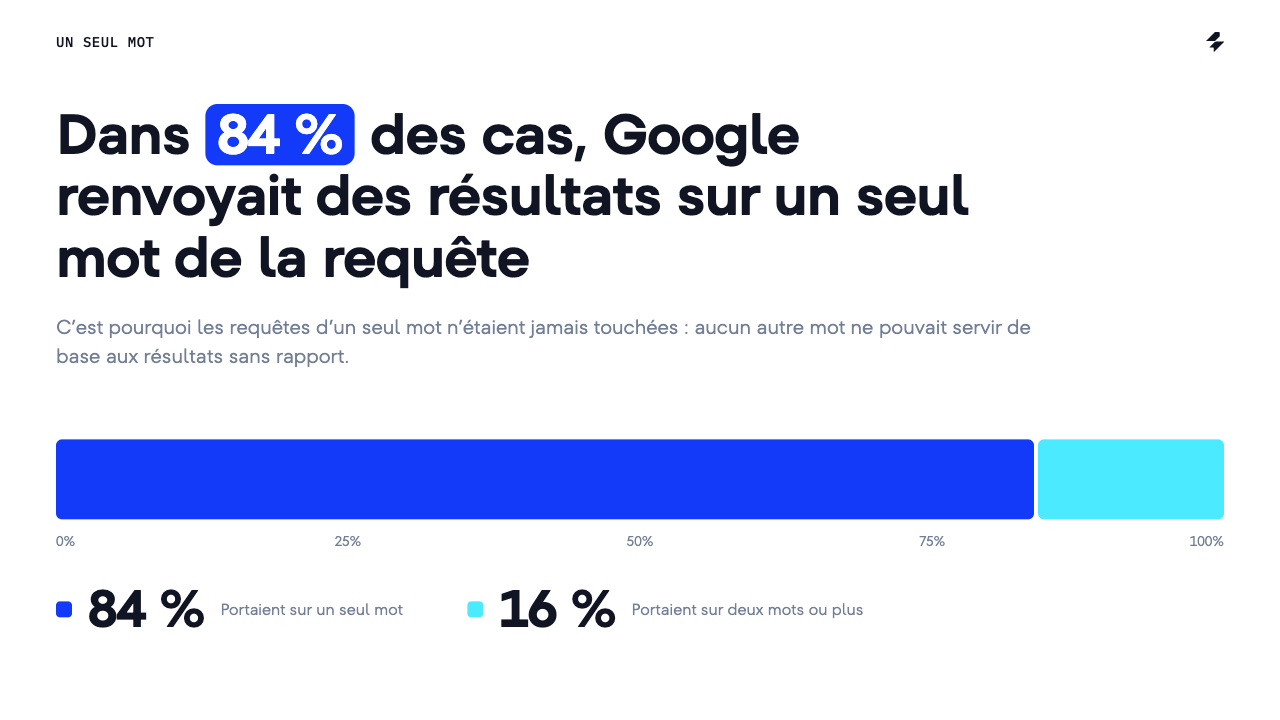
Dans 84 % des cas, Google renvoyait des résultats portant sur un seul mot de la requête.
Par exemple, « business bank line of credit » (ligne de crédit bancaire pour entreprise) a fait remonter des résultats sur le mot « line » : l’application de messagerie Line, The Line Hotel et Florida Georgia Line, au lieu du financement des entreprises.
-
Les résultats Google sans corrélation commençaient presque toujours au-delà du top 8.
Dans 96,5 % des cas, le bloc de résultats sans rapport débutait en position 9 ou plus bas, dans 3,5 % entre les positions 6 et 8, et jamais dans le top 5.
Qu’appelle-t-on une SERP sans rapport ?
Une SERP sans rapport, parfois appelée « SERP empoisonnée » (poisoned SERP), est une page de résultats renvoyée à une vérification automatisée : elle semble valide, mais contient des résultats trompeurs.
Prenons une requête de notre étude : « business bank line of credit » (ligne de crédit bancaire pour entreprise). Les neuf premiers résultats correspondaient aux banques et organismes de crédit attendus, comme Chase, US Bank, PNC et LendingTree.
La page 2, en revanche, ne parlait pas du tout de crédit aux entreprises. On y trouvait des clips musicaux, l’application de messagerie LINE et The LINE Hotel. Ces résultats partageaient le mot « line » avec la requête, mais aucun n’y répondait, et aucun n’apparaissait pour cette même requête lors de nos vérifications de référence.
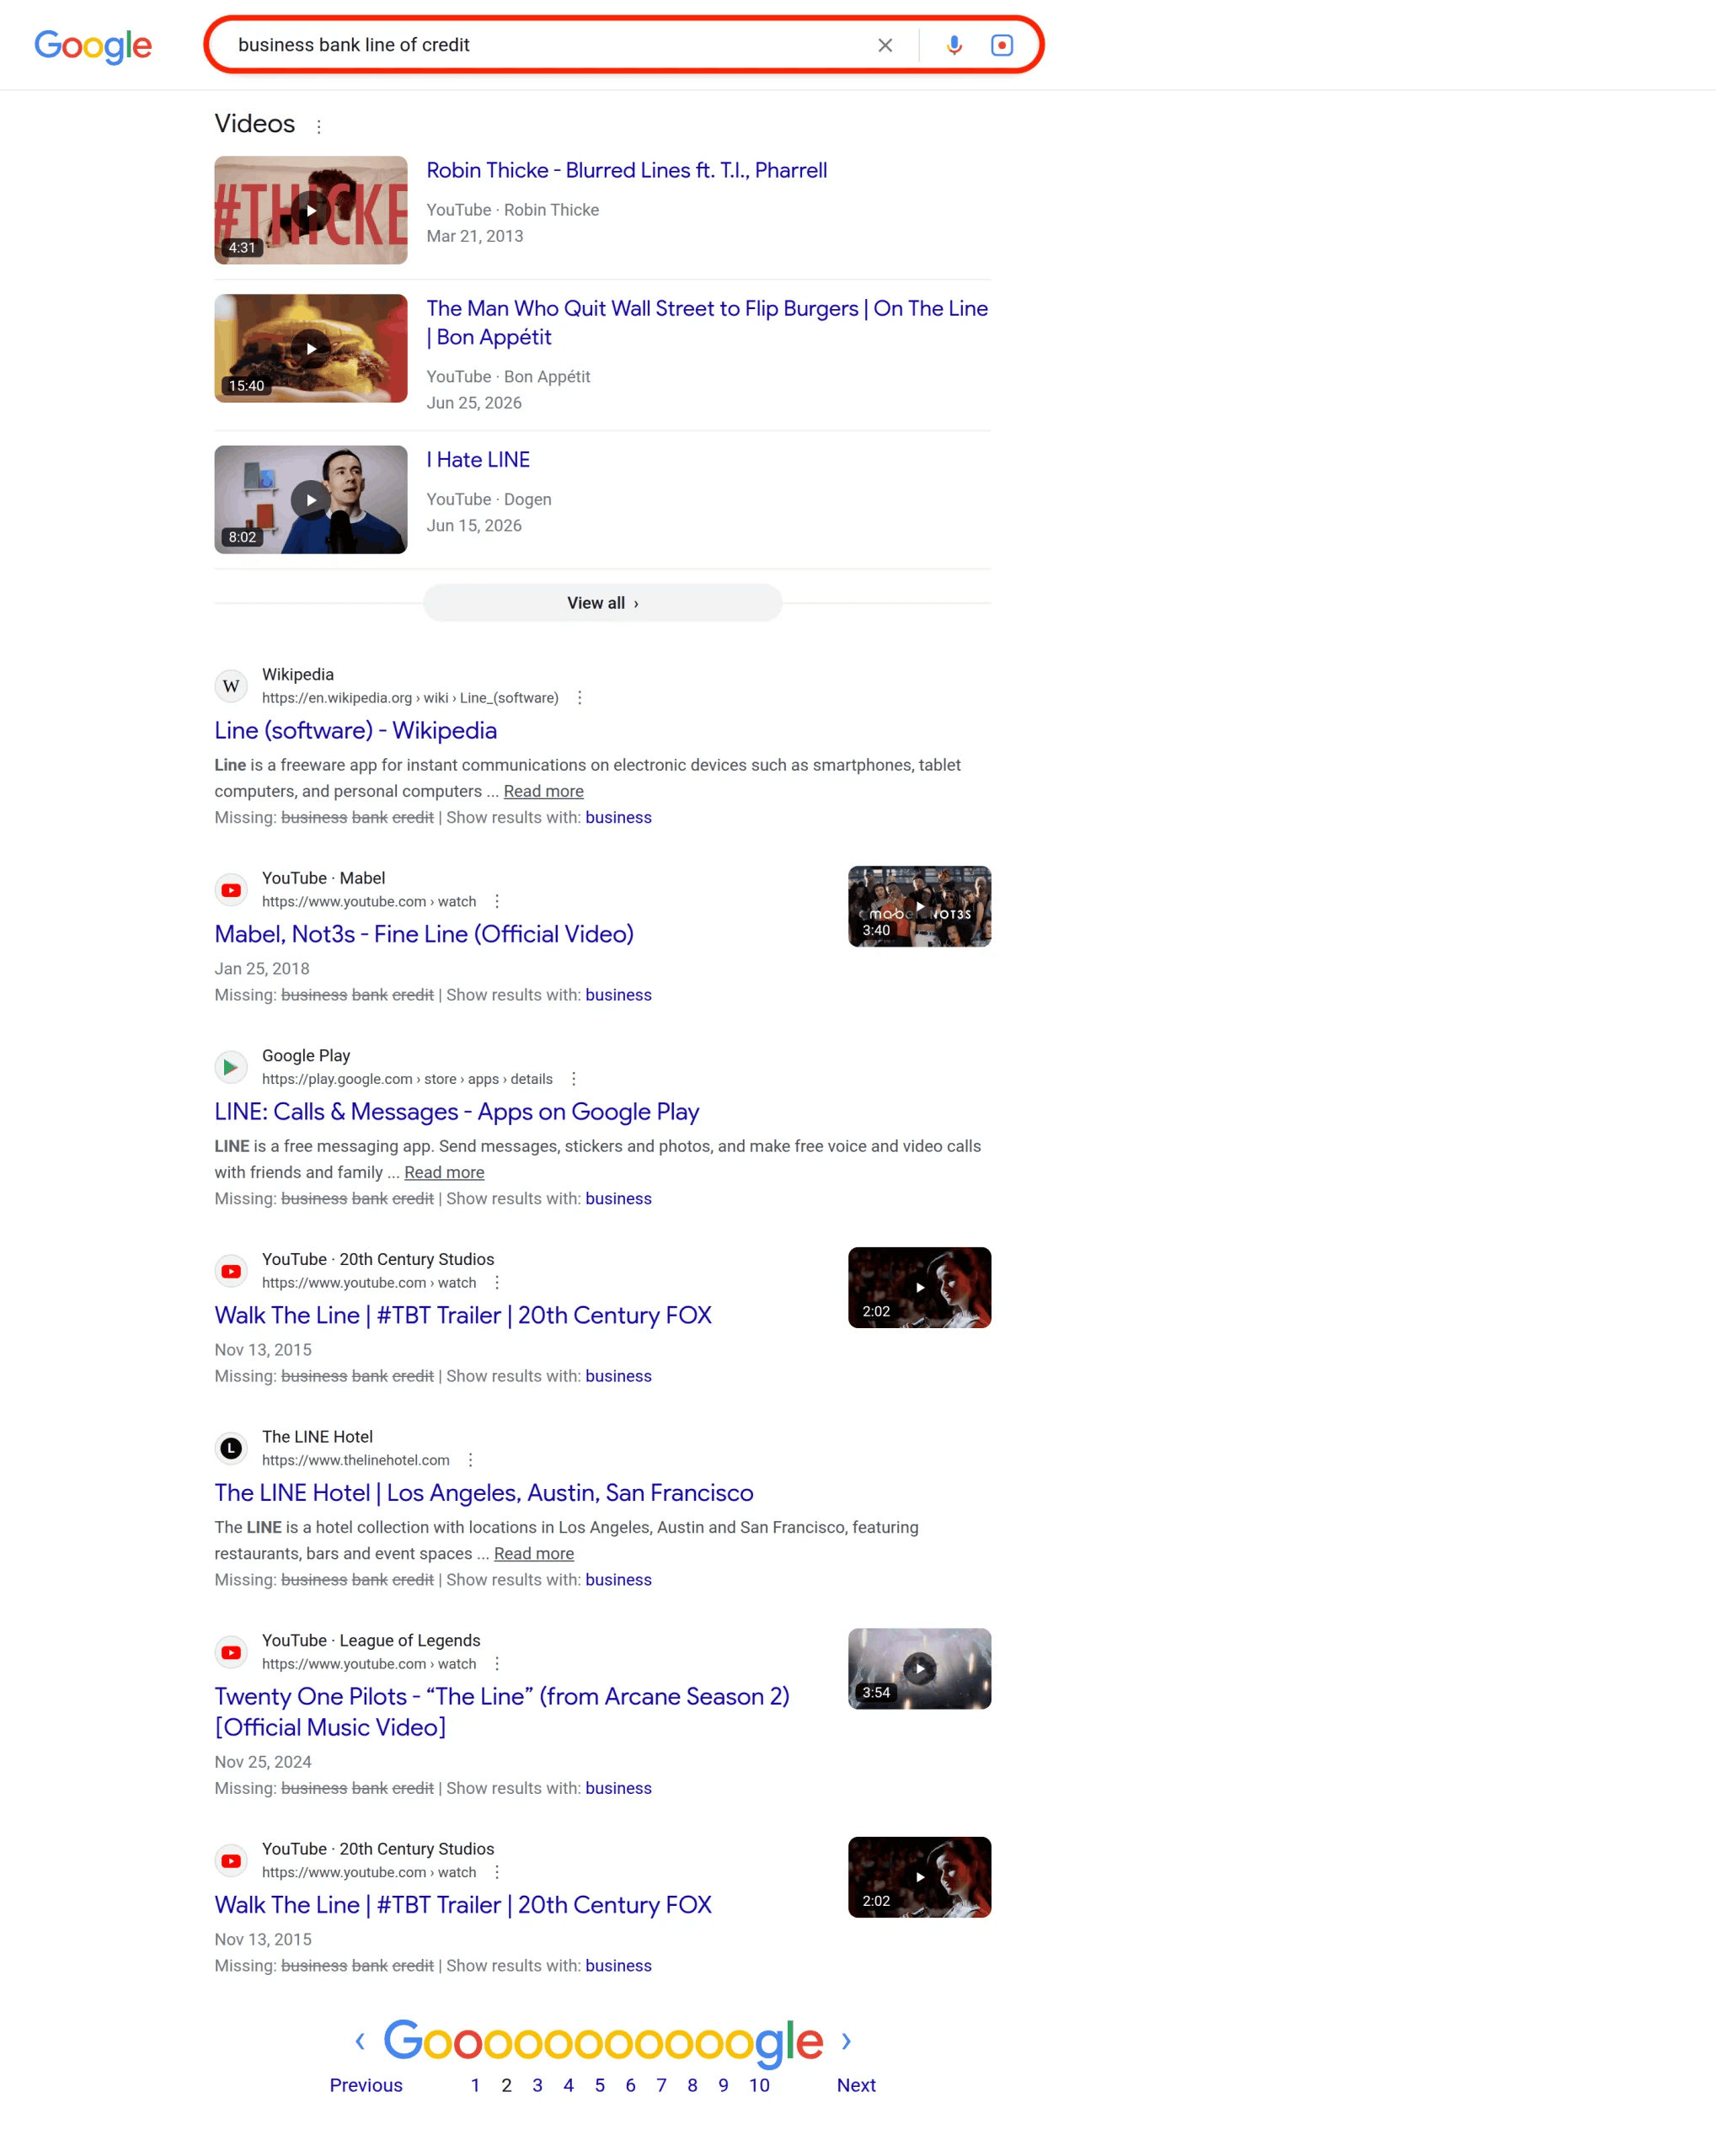
Du point de vue des outils de suivi de positions, la vérification semble avoir fonctionné : Google a renvoyé ce qui ressemble à une page de résultats valide.
Mais si un site web n’apparaît pas dans ces résultats, l’outil peut enregistrer une chute dans le classement alors que sa position réelle n’a pas bougé. Aucun message d’erreur ne vient signaler l’anomalie, qui ne saute aux yeux qu’en examinant le sujet des résultats.
Ce que la communauté SEO a remarqué
Début octobre, des experts du SEO s’inquiétaient de données de classement qui ne semblaient pas correspondre à ce qu’ils voyaient dans Google. Barry Schwartz a rassemblé nombre de ces observations dans son article pour Search Engine Roundtable, dont les commentaires ci-dessous.
Le 9 octobre, Lily Ray expliquait que cette incertitude l’empêchait de partager son analyse :
Le même jour, Alex Wolk a indiqué vérifier manuellement des requêtes en navigation privée avant de se fier aux mouvements signalés par les outils de suivi.
D’autres cherchaient à expliquer ce décalage.
Antony Deroshan a par exemple avancé que Google identifiait le trafic automatisé et renvoyait des résultats de piètre qualité au lieu de bloquer purement et simplement les requêtes. Il s’agissait de son interprétation, et non d’une explication confirmée par Google.
Le 10 octobre, Marty Eigner a résumé son expérience plus crûment :
Le sujet a aussi fait réagir la communauté SEO francophone. Abondance y a consacré un article dès le 15 octobre, et plusieurs consultants ont partagé leurs propres recommandations pour interpréter ces données :
- Le 12 octobre, le consultant SEO Alexis Marques conseillait de vérifier les impressions et les clics dans Search Console avant de tirer des conclusions d’une chute d’un jour, et indiquait qu’il signalerait « la période comme peu fiable » dans les rapports de septembre et d’octobre.
- Le 24 octobre, la consultante SEO et GEO Nelly Kempf rappelait qu’une chute d’un jour dans un outil de suivi « ne suffit pas pour poser un diagnostic » et invitait à comparer l’historique du mot-clé sur plusieurs semaines.
Ces observations ont attiré l’attention sur le problème. Les enquêtes des fournisseurs l’ont ensuite chiffré :
- Le 21 octobre, Nozzle a publié une étude classant 22,6 % des SERPs évaluées depuis le 13 septembre comme « empoisonnées », avec un pic quotidien de 43,5 % le 30 septembre. Par pays ciblé, la France se classait 42e sur 45 avec 5,3 %, la Belgique 6e avec 15,9 %, la Suisse 5e avec 16,1 % et le Canada 23e avec 11,0 %.
- Le 1er novembre, Keyword.com a publié une analyse classant 13,1 % des SERPs du 13 septembre au 14 octobre comme « empoisonnées », contre 0,3 % en août. Pour google.fr, l’analyse aboutissait à 9,4 %.
Les chiffres varient, car chaque fournisseur a étudié des mots-clés, des dates et des méthodes de collecte différents. Ils révèlent néanmoins un problème commun : Google renvoyait des résultats peu fiables à plusieurs fournisseurs.
Pourquoi Google renverrait-il ces résultats ?
Selon une théorie avancée par Derek Perkins, de Nozzle, Google chercherait à perturber le scraping par l’IA en renvoyant des résultats trompeurs plutôt qu’en bloquant purement et simplement les requêtes automatisées. Comme les outils de suivi de positions collectent eux aussi les résultats automatiquement, ils pourraient subir les mêmes mesures de défense.
Ricardo Batista, de Cloro, propose une explication voisine : Google semble orienter une partie du trafic automatisé vers un ensemble de résultats de moindre qualité. Selon lui, des réponses plausibles mais fausses peuvent être plus difficiles à détecter pour les scrapers qu’un blocage explicite.
Remarque : ces explications ne sont pas confirmées. Google ne s’est pas exprimé publiquement sur ces résultats trompeurs.
Ce que montrent 10 000 recherches Google
Nous avons étudié 10 000 mots-clés (Google aux États-Unis, sur desktop), en enregistrant jusqu’à 50 résultats organiques par mot-clé. Les données de septembre couvrent la période du 14 au 24 septembre, complétées par quatre vérifications supplémentaires les 14 et 15 octobre.
Sur les huit jours de la période de test, du 17 au 24 septembre, nous avons obtenu 80 000 cas : un mot-clé vérifié un jour donné compte pour un cas. Nous avons validé nos conclusions en plusieurs étapes, notamment par des vérifications manuelles des cas litigieux.
Pour en savoir plus sur la collecte et la validation des données, consultez la section consacrée à la méthodologie.
Résultats Google sans rapport : de 0,09 % à 57,3 % en une nuit
Pendant les trois premiers jours, la part estimée de mots-clés touchés est restée sous les 0,1 %. Puis tout a basculé. Le 16 septembre, elle était de 0,09 % ; le 17 septembre, elle atteignait 57,3 %.
Le taux est ensuite resté entre 56,9 % et 60,2 % jusqu’au 23 septembre.
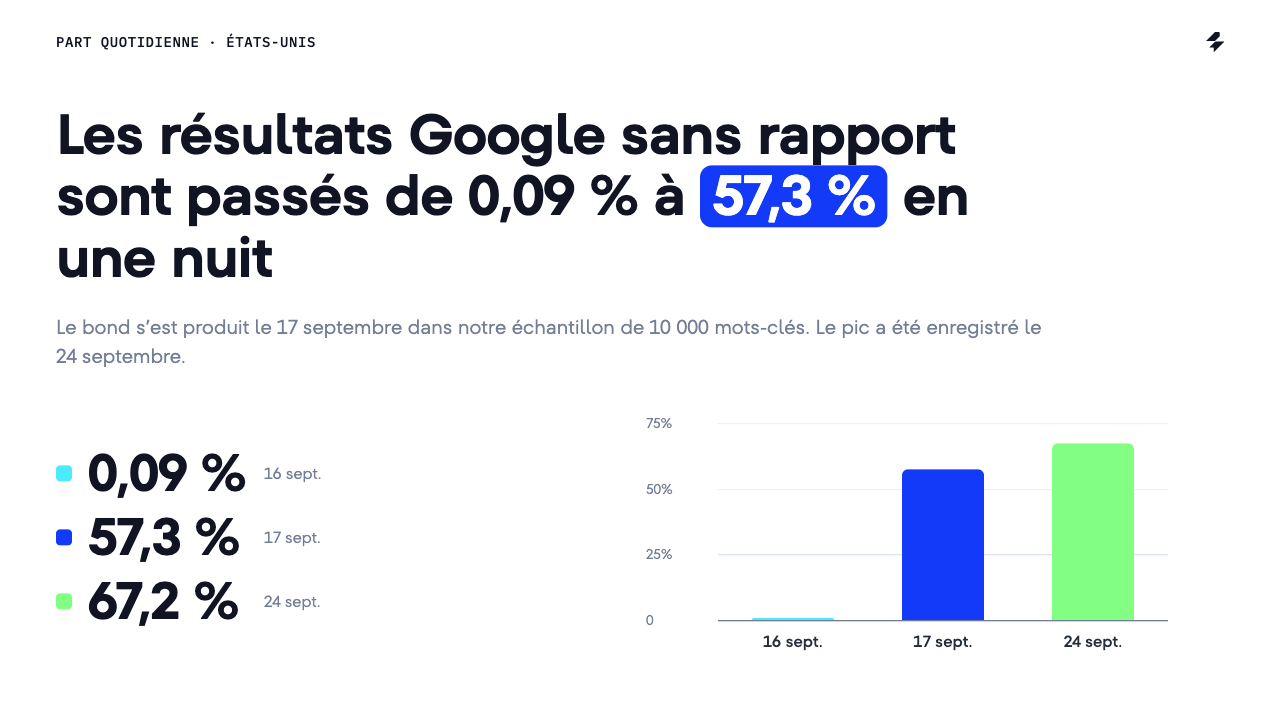
Il ne s’agissait pas d’une vérification isolée et inhabituelle. Le phénomène s’est maintenu sur les huit jours de test. Le 24 septembre a enregistré le taux le plus élevé observé : 67,2 % des mots-clés de notre échantillon renvoyaient des résultats sans rapport.
Dans 84 % des cas, les résultats portaient sur un seul mot de la requête
Les résultats sans rapport avaient souvent un point commun : ils portaient sur un seul mot tiré de la requête. Le reste de l’expression (et ce que l’internaute cherchait réellement) semblait passer à la trappe.
Par exemple, « business bank line of credit » devrait renvoyer des informations sur le financement des entreprises. Au lieu de cela, une partie des résultats mentionnait l’application de messagerie Line, The Line Hotel, la High Line et le groupe Florida Georgia Line. Tous avaient un lien avec « line » (ligne), mais aucun ne répondait à la requête entière.
Nous avons observé le même phénomène sur d’autres recherches :
Mot sur lequel portaient les résultats sans rapport
line (ligne)
Exemples de résultats renvoyés
Application de messagerie Line, The Line Hotel, la High Line, Florida Georgia Line
Mot sur lequel portaient les résultats sans rapport
into (en)
Exemples de résultats renvoyés
intostudy.com, into.org, intoglobal.com, into-tampere.org
Mot sur lequel portaient les résultats sans rapport
own (propre)
Exemples de résultats renvoyés
Chaîne OWN d’Oprah, « In Their Own Words », podcast « Mind Your Own »
Mot sur lequel portaient les résultats sans rapport
pot (marmite)
Exemples de résultats renvoyés
The Melting Pot, restaurants Lobster Pot, Petit Pot, Dogipot
Mot sur lequel portaient les résultats sans rapport
dry (sec)
Exemples de résultats renvoyés
Dry January, réglementation des pressings, Dry Creek Vineyard, cacahuètes grillées à sec
line (ligne)
Application de messagerie Line, The Line Hotel, la High Line, Florida Georgia Line
into (en)
intostudy.com, into.org, intoglobal.com, into-tampere.org
own (propre)
Chaîne OWN d’Oprah, « In Their Own Words », podcast « Mind Your Own »
pot (marmite)
The Melting Pot, restaurants Lobster Pot, Petit Pot, Dogipot
dry (sec)
Dry January, réglementation des pressings, Dry Creek Vineyard, cacahuètes grillées à sec
Dans 84 % des cas, les résultats sans rapport étaient associés à un seul mot de la recherche d’origine. Dans les 16 % restants, des groupes successifs de résultats renvoyaient à deux mots ou plus.
Les résultats portant sur un mot de la requête en partagent le vocabulaire, et souvent le type de site. Même la similarité cosinus entre ces pages et la requête d’origine est loin d’être nulle.
Concrètement, une vérification automatisée pouvait encore percevoir une certaine similarité, puisque les résultats correspondaient à une partie de la recherche, même s’ils ne répondaient pas à ce que l’internaute cherchait vraiment.
Voilà qui pourrait expliquer pourquoi les requêtes d’un seul mot de notre jeu de données n’ont jamais été touchées. Avec un seul mot dans la requête, aucun autre mot ne pouvait servir de base aux résultats sans rapport.
Les cinq premiers résultats pouvaient sembler normaux
Les résultats sans rapport ne commençaient pas toujours en haut de la page. Une SERP pouvait s’ouvrir sur des résultats pertinents, puis basculer en cours de route.
Dans notre échantillon, les résultats sans rapport débutaient entre les positions 6 et 8 dans 3,5 % des séries de résultats touchées. Dans les 96,5 % des cas restants, la bascule se produisait plus bas dans la liste (en position 9 ou au-delà).
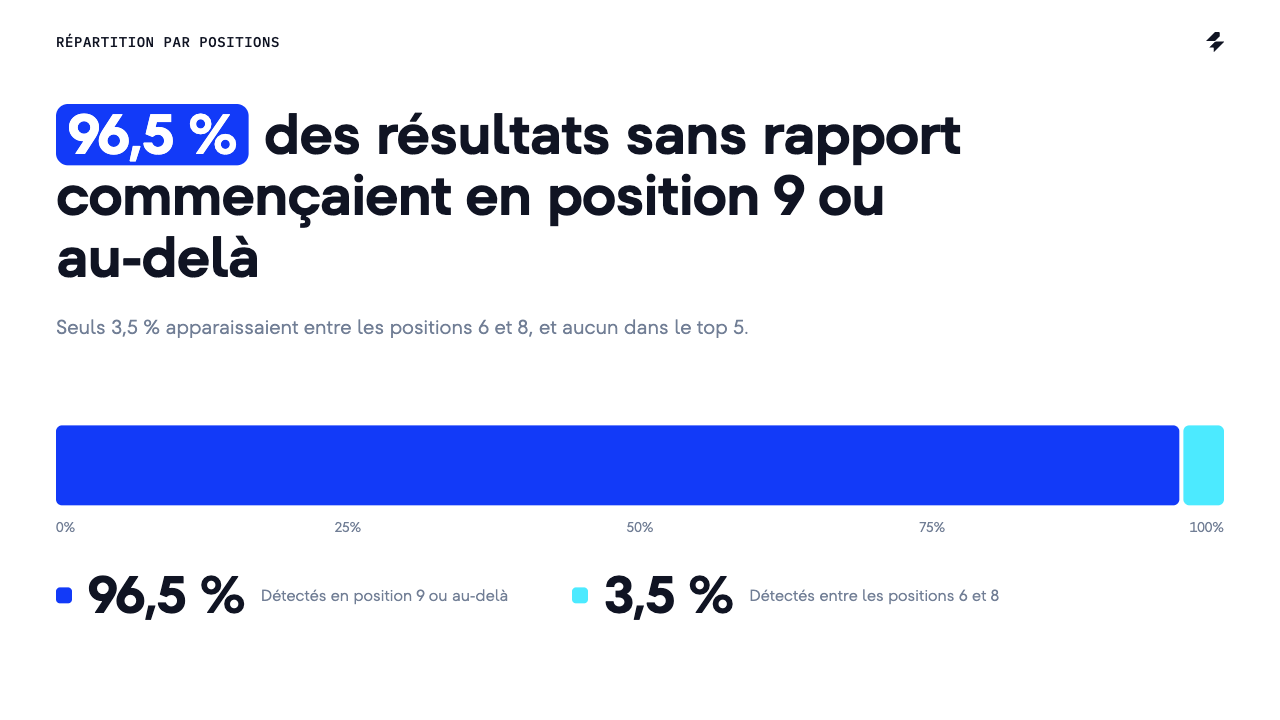
Un simple coup d’œil aux premiers résultats pouvait laisser croire que tout allait bien. Plus bas, en revanche, la SERP pouvait n’avoir plus grand-chose à voir avec la requête.
Si un site web se classe habituellement dans cette partie de la liste, des pages sans rapport peuvent donc prendre sa place dans les résultats collectés. L’outil risque alors de signaler le site comme absent ou en perte de positions, sans que cela signifie forcément que son classement a changé pour les internautes qui cherchent sur Google.
Facebook présent dans 45,2 % des résultats Google sans rapport, devant Reddit et Instagram
Les résultats sans rapport provenaient souvent de grandes plateformes. Facebook apparaissait dans 45,2 % des cas signalés, Reddit dans 41,3 % et Instagram dans 31,6 %.
La liste dépassait pourtant largement les réseaux sociaux : sites d’actualité, dictionnaires, boutiques d’applications et bases de données de recherche y figuraient aussi.
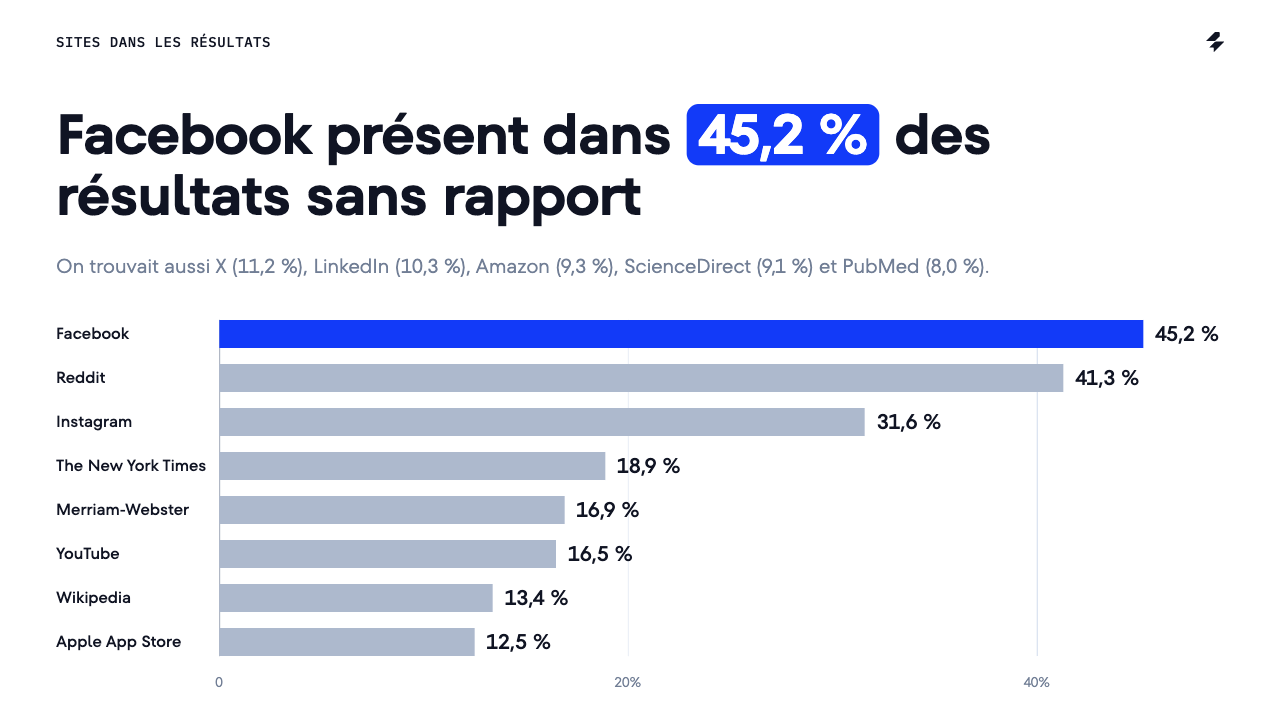
Merriam-Webster en offre un exemple particulièrement parlant. Le dictionnaire apparaissait dans environ un cas signalé sur six, avec la définition du mot sur lequel portaient les résultats sans rapport. La définition pouvait être exacte tout en ayant peu à voir avec ce que l’internaute recherchait.
La même distinction vaut pour les autres sites de la liste. Une entrée de dictionnaire, une publication Facebook ou un article de presse peuvent paraître crédibles en eux-mêmes. Pour repérer le problème, il faut vérifier s’ils répondent à la requête entière.
Que faire si une position semble anormale
Si une position vous semble inattendue, commencez par relancer une vérification dans votre outil de suivi de position. Avant de conclure à une perte de classement avérée, prenez le temps de comparer cette position avec l’historique récent du mot-clé.
- Observez la tendance. Un seul mot-clé a-t-il chuté, ou plusieurs ont-ils bougé en même temps ? Ne vous limitez pas à la veille pour voir si le mouvement persiste.
- Recoupez avec d’autres données. Cherchez des variations d’impressions et de clics dans Google Search Console pour la requête et la page concernées. Tenez compte des écarts de dates, de pays et d’appareil. Une seule comparaison ne suffira pas à établir la cause.
Si vous préparez un rapport client, vérifiez toute baisse soudaine et isolée avant de la présenter comme une perte de visibilité. À l’inverse, ne partez pas du principe que chaque changement inattendu vient d’un problème de données : un recul durable, confirmé par d’autres signaux, mérite une analyse SEO plus approfondie.
Méthodologie de l’étude
Nous avons analysé 10 000 mots-clés (Google aux États-Unis, sur desktop), en enregistrant jusqu’à 50 résultats organiques par mot-clé, avec leurs positions, URL et domaines. Les données couvrent la période du 14 au 24 septembre, avec quatre vérifications supplémentaires les 14 et 15 octobre. La période de test du 17 au 24 septembre représente 80 000 cas mot-clé/jour.
Nous avons vérifié les résultats en trois étapes :
- Constitution d’une référence pour chaque mot-clé. Pour chaque mot-clé, nous avons collecté tous les résultats renvoyés par Google lors de sept vérifications de référence hors de la période touchée : trois en septembre et quatre en octobre. Ensemble, ils formaient la liste des résultats habituels du mot-clé. Nous avons ensuite comparé chaque jour de test à cette référence, à deux niveaux. D’abord au niveau du domaine : un site jamais apparu pour le mot-clé lors d’un jour de référence était considéré comme inconnu. Ce critère ne suffisait pas, car de nombreuses pages sans rapport se trouvaient sur des domaines présents pour presque toutes les requêtes, comme Facebook, Reddit, YouTube et The New York Times. Une vérification par domaine les aurait jugées normales. Pour les domaines déjà présents dans la référence, nous avons donc aussi vérifié si la page elle-même était apparue pour ce mot-clé. Par exemple, une publication Facebook sur Deadpool (« the fans got Deadpool off the ground so many years ago », soit « ce sont les fans qui ont lancé Deadpool il y a tant d’années ») est apparue pour « how many calories do Americans eat on Thanksgiving » (combien de calories les Américains mangent-ils à Thanksgiving). Le domaine facebook.com passe le contrôle par domaine, mais la publication échoue au contrôle par page : elle ne correspondait à la requête que par le mot « many » (beaucoup).
- Distinction entre changements suspects et fluctuations normales. Une page qui échoue au contrôle de référence n’est pas forcément sans rapport. Les classements évoluent, de nouvelles pages apparaissent, et les positions basses bougent davantage que les hautes. Pour chaque cas, nous avons donc calculé la part de résultats inconnus à l’un ou l’autre niveau, et signalé le cas dès que cette part atteignait 50 %. Nous avons aussi examiné les cas sous ce seuil pour repérer des séries plus courtes de résultats sans rapport.
- Validation des conclusions. Nous avons sélectionné 750 cas comportant des résultats inconnus, ainsi que 150 cas de jours de référence servant de groupe témoin, puis examiné leurs titres et descriptions de page. Deux évaluateurs IA ont analysé chaque cas de manière indépendante, sans connaître la date ni le verdict de l’algorithme. En cas de désaccord, nous avons examiné 40 cas manuellement pour définir une règle de départage. Aucun cas du groupe témoin n’a été jugé sans rapport. Les chiffres quotidiens de cet article sont pondérés par les résultats de cette revue : ils tiennent donc compte à la fois des faux positifs parmi les cas signalés et des résultats sans rapport que l’algorithme n’a pas détectés.
Avertissement : Ces conclusions ne valent que pour cet échantillon. Les paramètres de collecte des vérifications d’octobre différaient de ceux de septembre. Nous avons examiné uniquement les résultats organiques, à l’exclusion des aperçus IA (AI Overviews), des annonces et des autres fonctionnalités de recherche. Les données ne disent rien de l’intention de Google, de la durée du problème au cours d’une journée, ni de ce que voyaient les internautes qui cherchaient directement sur Google. SE Ranking n’est pas affilié à Google.