Los resultados irrelevantes de Google afectaron a más del 57 % de las palabras clave de un día para otro: lo que revela nuestro estudio
Desde septiembre de 2026, los equipos SEO y las herramientas de seguimiento de posiciones detectan algo extraño en los datos de ranking de Google. Algunos sitios web desaparecen de repente de los resultados y, en su lugar, aparecen páginas que nunca antes se habían mostrado. La consulta de posiciones se completa sin errores aparentes, pero los datos que devuelve Google no se corresponden con la búsqueda realizada.
El origen podría estar en un problema que Google intenta resolver: los bots que extraen sus resultados de búsqueda de forma masiva. Como explican sus políticas, las consultas automatizadas consumen recursos y pueden afectar a su capacidad de atender a los usuarios.
Parte de la comunidad SEO sospecha que Google está intentando frenar específicamente el scraping relacionado con la IA y que las herramientas de seguimiento de posiciones, que también recopilan resultados de forma automatizada, se están viendo afectadas por las mismas medidas de protección.
En SE Ranking, nuestro equipo trabaja para responder a estos cambios desde el primer momento.

Nota: Puedes seguir las últimas novedades en nuestra página de estado. Si detectas algún problema en tus datos de ranking, escribe a nuestro equipo de soporte en [email protected] e incluye el nombre del proyecto y algunas palabras clave de ejemplo para que podamos investigarlo.
Además de este trabajo continuo, queríamos saber hasta qué punto se habían extendido estos resultados irrelevantes y qué patrones seguían. Para ello, estudiamos 10 000 palabras clave de nuestro índice de investigación, un conjunto de palabras clave reservado exclusivamente para estudios, independiente de los proyectos y las cuentas de nuestros clientes.
Analizamos los resultados de Google en EE. UU. para búsquedas desde ordenadores, recopilados en septiembre y octubre de 2026, para determinar con qué frecuencia aparecían resultados irrelevantes, qué tipo de páginas mostraban y en qué posición empezaban a aparecer.
Estos son nuestros hallazgos.
-
Los resultados irrelevantes de Google afectaron al 57,3 % de las palabras clave de un día para otro, frente al 0,09 % del día anterior.
El salto se produjo el 17 de septiembre en nuestra muestra de 10 000 palabras clave.
-
El 24 de septiembre, la proporción de palabras clave afectadas alcanzó el 67,2 %.
Fue el valor más alto registrado durante el periodo de estudio.
-
En el 84 % de los casos, Google devolvió resultados relacionados con una sola palabra de la búsqueda.
Por ejemplo, «business bank line of credit» (línea de crédito bancaria para empresas) mostró resultados sobre la palabra «line»: la app de mensajería Line, The Line Hotel y Florida Georgia Line, en lugar de información sobre financiación empresarial.
-
Los resultados irrelevantes casi siempre aparecían a partir de la novena posición.
El 96,5 % de los bloques con resultados irrelevantes empezaba en la posición 9 o más abajo, el 3,5 % entre las posiciones 6 y 8, y ninguno entre las cinco primeras posiciones.
¿Qué son las SERPs con resultados irrelevantes?
Una SERP con resultados irrelevantes, también llamada «SERP envenenada» (poisoned SERP), es una página de resultados que Google devuelve en respuesta a una consulta automatizada y que parece válida, pero contiene resultados que no guardan relación con la búsqueda.
Por ejemplo, una de las búsquedas de nuestro estudio fue «business bank line of credit». Los nueve primeros resultados eran los bancos y entidades de crédito que cabría esperar, como Chase, US Bank, PNC y LendingTree.
En la segunda página no había nada sobre crédito para empresas. Aparecían vídeos musicales, la app de mensajería LINE y The LINE Hotel. Todos compartían con la búsqueda la palabra «line», pero ninguno respondía a ella. Además, ninguno de ellos había aparecido para esa misma consulta en nuestras consultas de referencia.
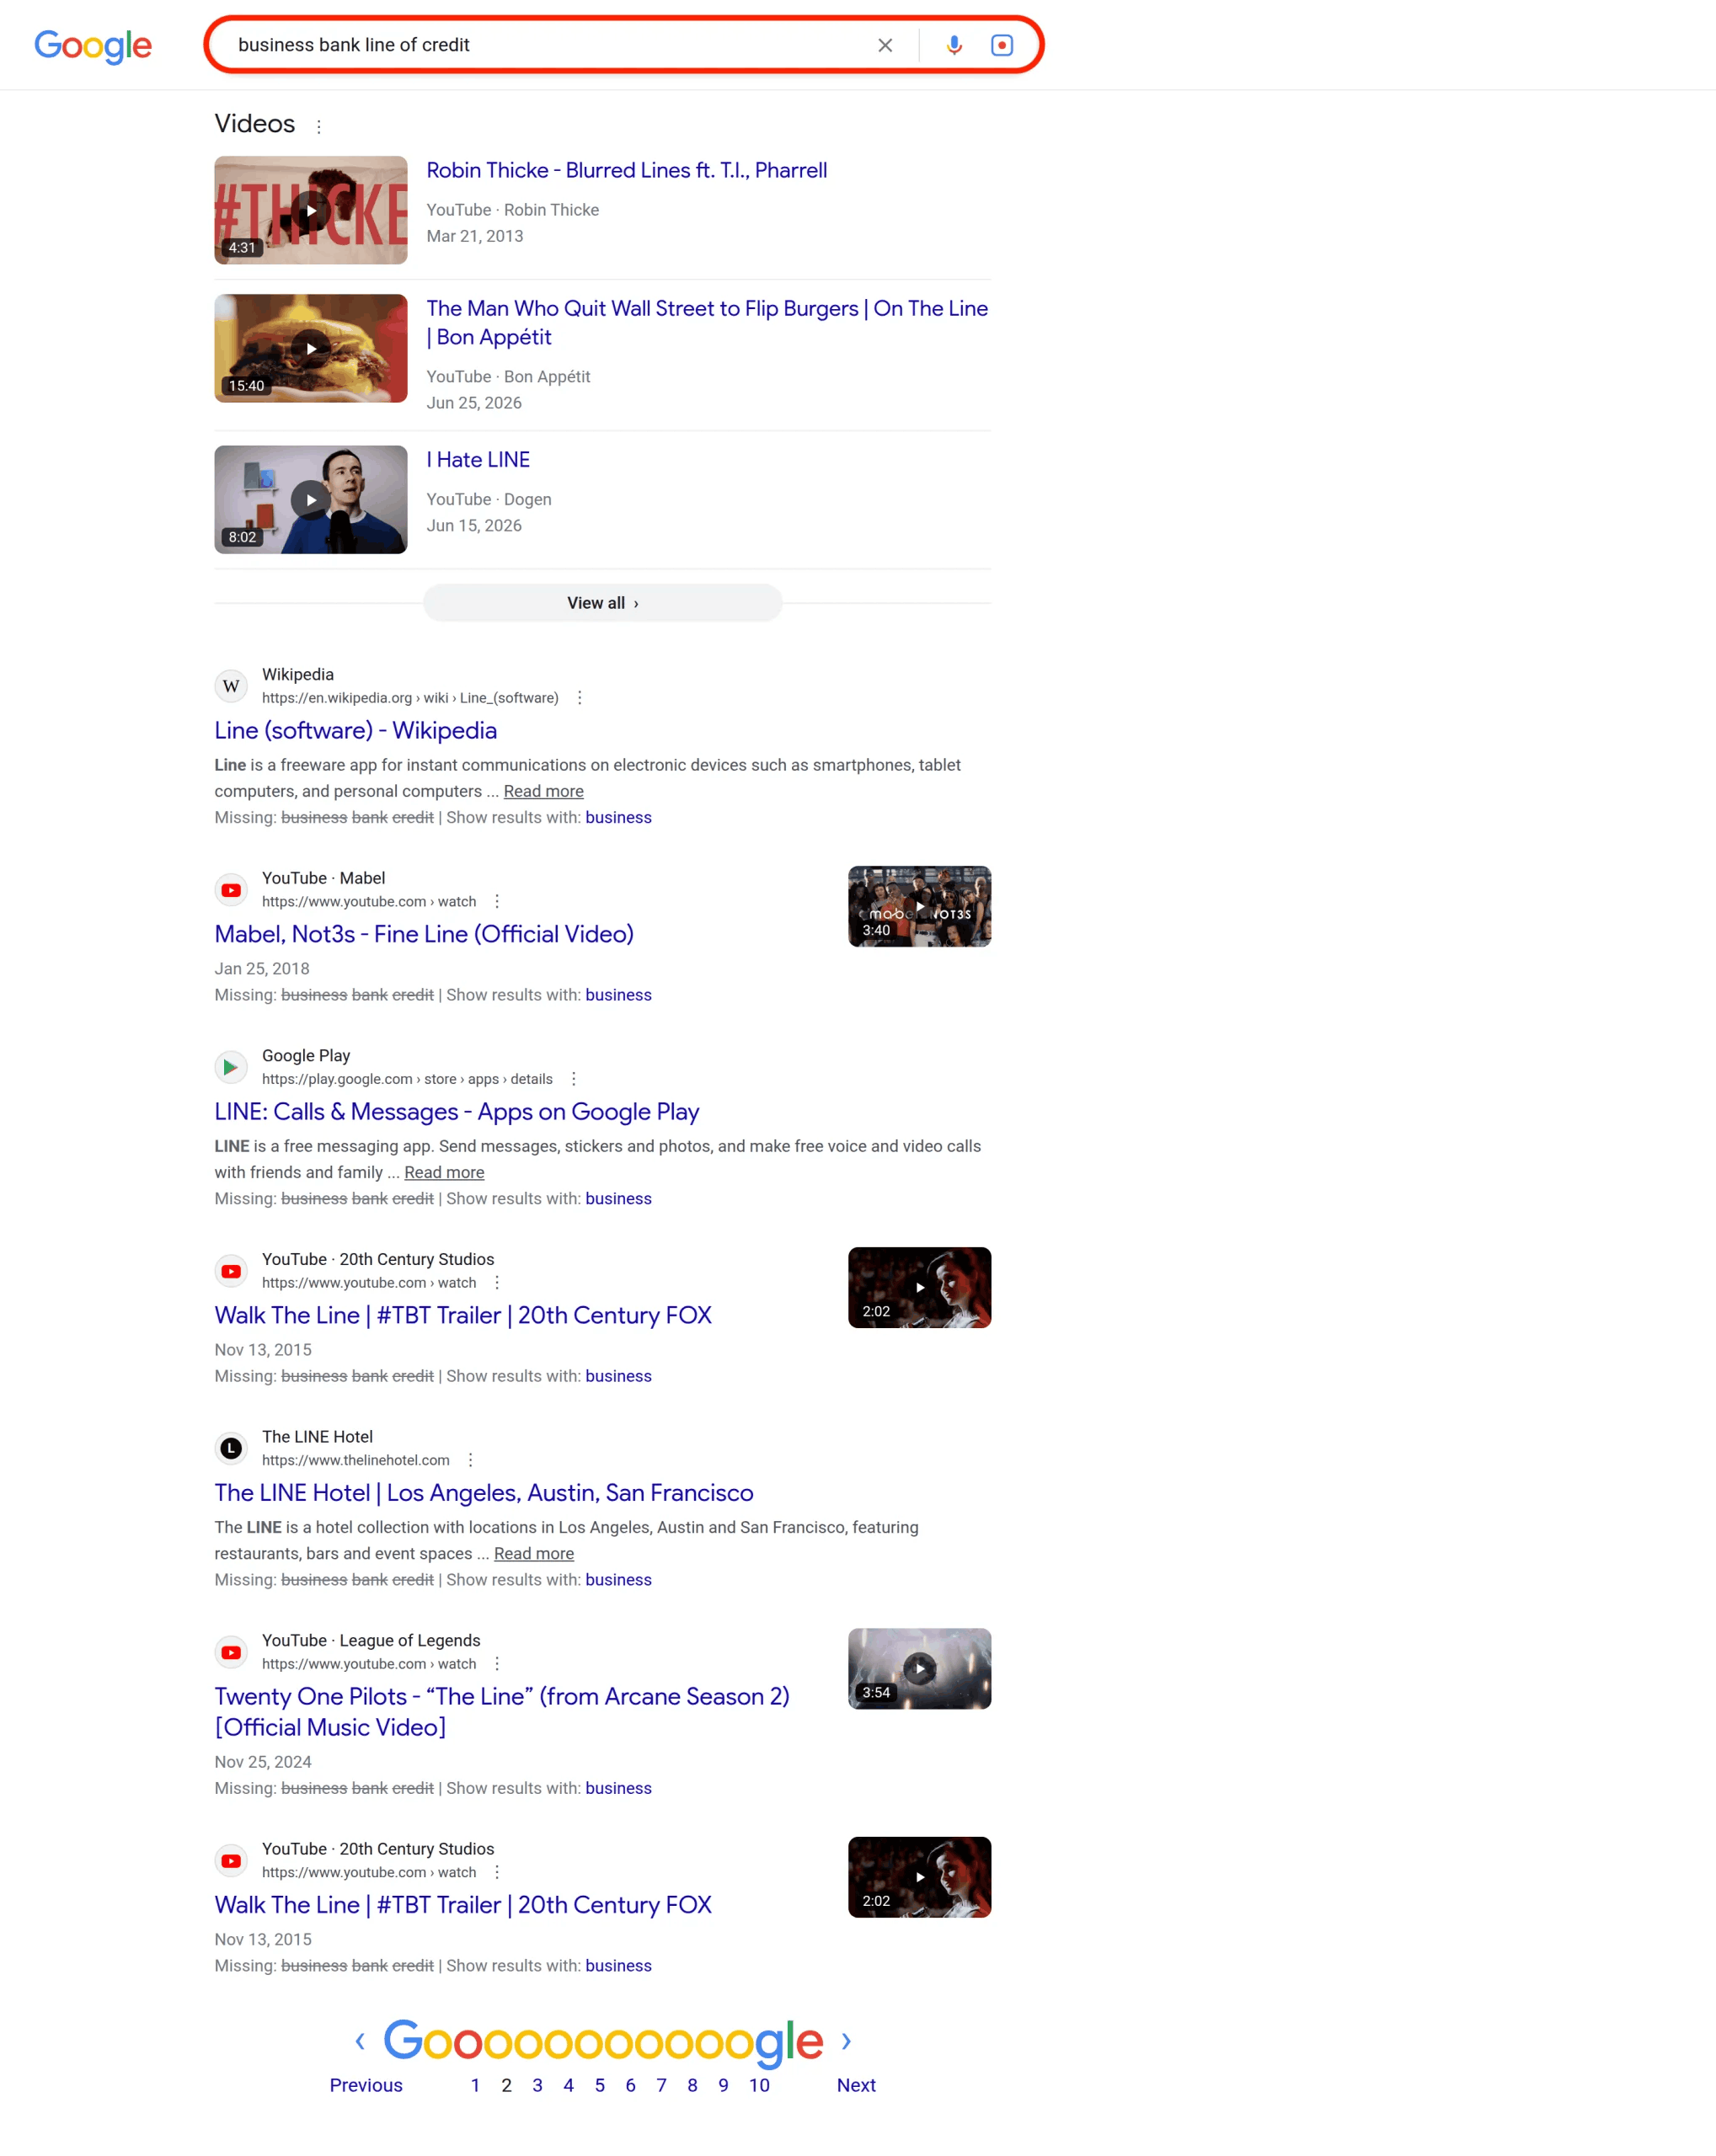
Para una herramienta de seguimiento de posiciones, la consulta parece haber funcionado: Google ha devuelto lo que aparenta ser una página de resultados válida.
Sin embargo, si un sitio web no aparece entre esos resultados, la herramienta puede registrar una caída de posiciones aunque su posición real no haya cambiado. No se muestra ningún mensaje de error que permita detectar el problema. Este solo se hace evidente al examinar la temática de los resultados.
Lo que ha detectado la comunidad SEO
A principios de octubre, varios profesionales SEO empezaron a expresar su preocupación por las discrepancias entre los datos de ranking y los resultados que veían al consultar Google. Barry Schwartz recopiló muchas de estas observaciones en su artículo de Search Engine Roundtable, entre ellas los comentarios que recogemos a continuación.
El 9 de octubre, Lily Ray comentó que la incertidumbre le impedía compartir su análisis:
Ese mismo día, Alex Wolk explicó que comprobaba las búsquedas manualmente en una ventana de incógnito antes de fiarse de los movimientos que mostraban las herramientas de seguimiento.
Otros debatían cuál podía ser la causa de esa discrepancia.
Antony Deroshan, por ejemplo, sugirió que Google estaba identificando el tráfico automatizado y devolviendo resultados basura en lugar de bloquear directamente las solicitudes. Era su interpretación, no una explicación confirmada por Google.
El 10 de octubre, Marty Eigner resumió su experiencia de forma más tajante:
El debate también llegó a la comunidad SEO hispanohablante. A finales de octubre, varios profesionales publicaron sus propias recomendaciones para interpretar estos datos:
- El 25 de octubre, Ton Rigol, fundador de la agencia mexicana Rigol&Co, aconsejó no reaccionar ante una caída de un solo día: esperar unos días, contrastarla con Search Console y compararla con las semanas anteriores, no con el día anterior.
- El 26 de octubre, Elu Gonzalez, experto en SEO y optimización web, advirtió de que estas semanas conviene tomar con cautela los datos de los trackers y recomendó verificar cualquier movimiento en Search Console antes de actuar.
- El 28 de octubre, el consultor SEO Saúl Sánchez señaló que estas herramientas siguen siendo útiles para detectar tendencias y vigilar a la competencia, pero que «el riesgo está en reaccionar demasiado rápido».
Estas observaciones sirvieron para dar la voz de alarma. Después, las investigaciones de varios proveedores pusieron cifras al problema:
- Nozzle, 21 de octubre: Su estudio clasificó como «envenenadas» el 22,6 % de las SERPs evaluadas desde el 13 de septiembre, con un pico diario del 43,5 % el 30 de septiembre. Por país de destino, España registró un 4,8 % (puesto 43 de 45 países), México un 10,4 % (puesto 28), Argentina un 11,3 % (puesto 19) y Colombia un 12,9 % (puesto 13).
- Keyword.com, 1 de noviembre: Su análisis clasificó como «envenenadas» el 13,1 % de las SERPs entre el 13 de septiembre y el 14 de octubre, frente al 0,3 % de agosto. Para google.es, el análisis obtuvo un 8,0 %, el valor más bajo de los 16 mercados que analizó.
Las cifras varían porque cada proveedor analizó palabras clave, fechas y métodos de recopilación distintos. Aun así, todas apuntan a un mismo problema: Google estaba devolviendo resultados poco fiables a varios proveedores.
¿Por qué podría Google mostrar estos resultados?
Una de las teorías, planteada por Derek Perkins, de Nozzle, es que Google intenta frenar el scraping para IA devolviendo resultados engañosos en lugar de bloquear directamente las solicitudes automatizadas. Como las herramientas de seguimiento de posiciones también recopilan resultados de forma automática, podrían estar viéndose afectadas por las mismas medidas de protección.
Ricardo Batista, de Cloro, ofrece una explicación similar: Google parece redirigir parte del tráfico automatizado a un conjunto de resultados de menor calidad. Según él, a un scraper le cuesta más detectar unas respuestas verosímiles pero incorrectas que un bloqueo explícito.
Nota: Ninguna de estas explicaciones está confirmada. Google no ha explicado públicamente el origen de estos resultados engañosos.
Cómo se manifestó el problema en 10 000 búsquedas de Google
Analizamos 10 000 palabras clave de Google en EE. UU. para búsquedas desde ordenadores y recopilamos hasta 50 resultados orgánicos por palabra clave. Los datos de septiembre abarcan el periodo del 14 al 24 de septiembre, y se completan con cuatro consultas adicionales los días 14 y 15 de octubre.
Durante los ocho días del periodo de prueba, del 17 al 24 de septiembre, obtuvimos 80 000 casos. Cada caso corresponde a una palabra clave consultada en un día concreto. Validamos los resultados en varias fases, que incluyeron revisiones manuales de los casos dudosos.
Si quieres saber más sobre cómo recopilamos y validamos los datos, consulta la sección de metodología.
Los resultados irrelevantes pasaron del 0,09 % al 57,3 % de un día para otro
Durante los tres primeros días, la proporción estimada de palabras clave afectadas se mantuvo por debajo del 0,1 %. Después cambió de forma brusca. El 16 de septiembre era del 0,09 %; el 17 de septiembre alcanzó el 57,3 %.
La tasa se mantuvo entre el 56,9 % y el 60,2 % hasta el 23 de septiembre.
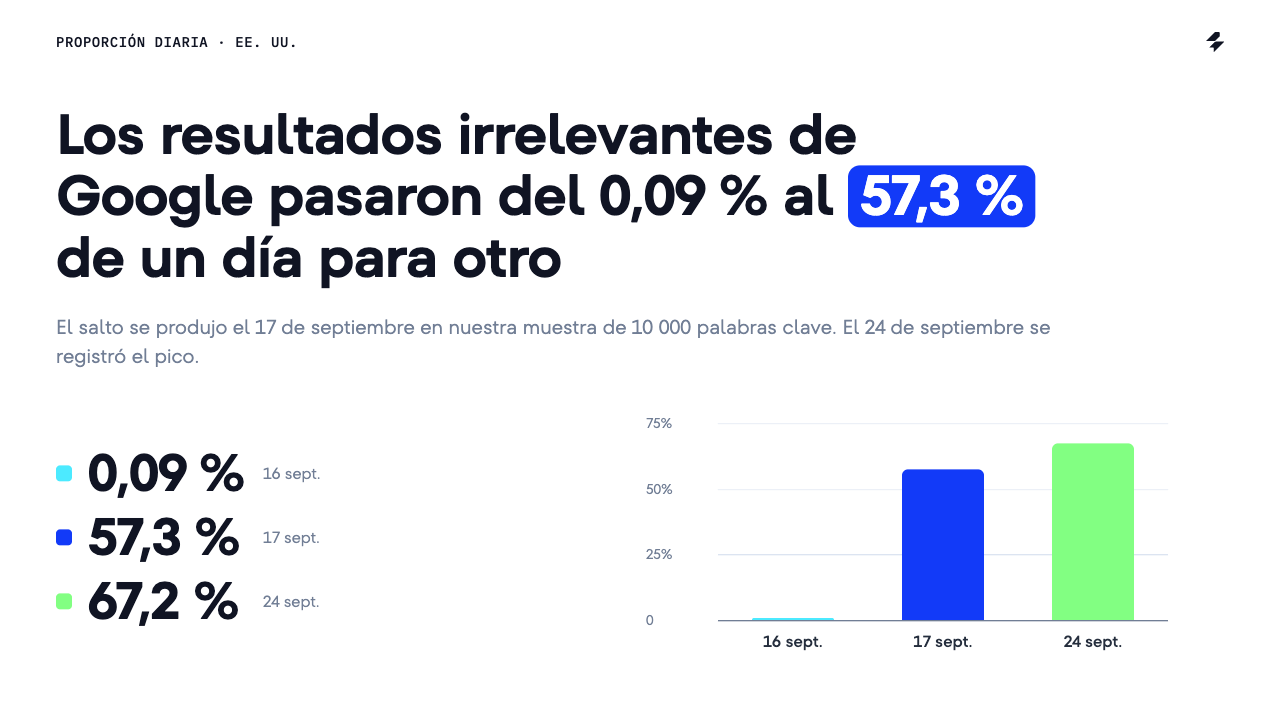
No fue una anomalía puntual de una sola consulta. El patrón se repitió durante los ocho días de prueba. El 24 de septiembre registramos la tasa más alta: el 67,2 % de las palabras clave de nuestra muestra devolvió resultados irrelevantes.
En el 84 % de los casos, los resultados respondían a una sola palabra de la búsqueda
Los resultados irrelevantes solían tener algo en común: trataban sobre una única palabra extraída de la búsqueda. El resto de la frase, y lo que la persona quería encontrar realmente, parecía quedar fuera.
Por ejemplo, «business bank line of credit» debería devolver información sobre financiación empresarial. Sin embargo, parte de los resultados incluía la app de mensajería Line, The Line Hotel, el parque High Line y el grupo Florida Georgia Line. Todos guardaban relación con «line», pero ninguno respondía a la búsqueda completa.
Vimos lo mismo con otras búsquedas:
Palabra sobre la que trataban los resultados irrelevantes
line
Ejemplos de resultados devueltos
App de mensajería Line, The Line Hotel, el High Line, Florida Georgia Line
Palabra sobre la que trataban los resultados irrelevantes
into
Ejemplos de resultados devueltos
intostudy.com, into.org, intoglobal.com, into-tampere.org
Palabra sobre la que trataban los resultados irrelevantes
own
Ejemplos de resultados devueltos
La cadena OWN de Oprah, «In Their Own Words», el pódcast «Mind Your Own»
Palabra sobre la que trataban los resultados irrelevantes
pot
Ejemplos de resultados devueltos
The Melting Pot, los restaurantes Lobster Pot, Petit Pot, Dogipot
Palabra sobre la que trataban los resultados irrelevantes
dry
Ejemplos de resultados devueltos
Dry January, normativa sobre tintorerías (dry cleaners), Dry Creek Vineyard, cacahuetes tostados (dry roasted peanuts)
line
App de mensajería Line, The Line Hotel, el High Line, Florida Georgia Line
into
intostudy.com, into.org, intoglobal.com, into-tampere.org
own
La cadena OWN de Oprah, «In Their Own Words», el pódcast «Mind Your Own»
pot
The Melting Pot, los restaurantes Lobster Pot, Petit Pot, Dogipot
dry
Dry January, normativa sobre tintorerías (dry cleaners), Dry Creek Vineyard, cacahuetes tostados (dry roasted peanuts)
En el 84 % de los casos, los resultados irrelevantes estaban relacionados con una sola palabra de la búsqueda original. En el 16 % restante, los distintos bloques de resultados guardaban relación con dos o más palabras.
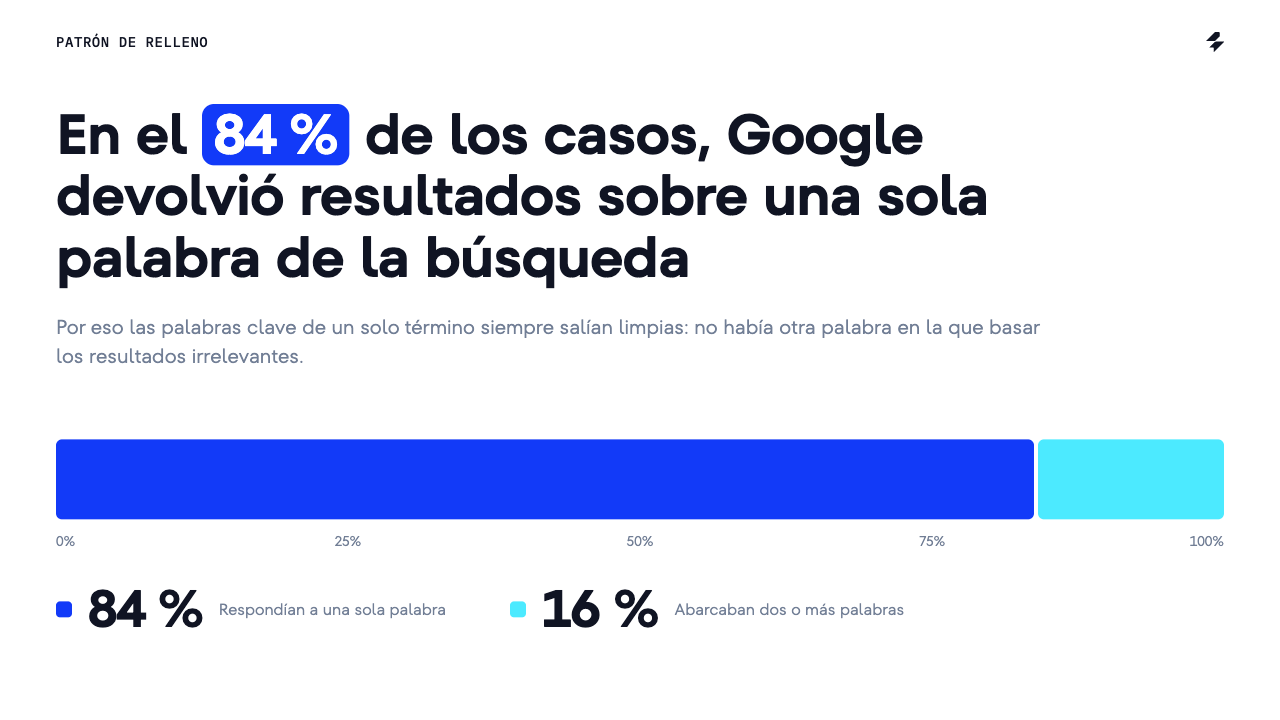
Los resultados relacionados con una palabra de la búsqueda compartían parte de su vocabulario y, a menudo, también el tipo de sitio web. Incluso la similitud del coseno entre esas páginas y la búsqueda original distaba mucho de ser cero.
Dicho de otro modo, una comprobación automática podría seguir detectando cierto grado de similitud: los resultados coincidían con parte de la búsqueda, aunque no respondieran a lo que la persona quería encontrar realmente.
Esto podría explicar por qué las palabras clave formadas por un único término de nuestro conjunto de datos siempre devolvían resultados relevantes. Si la búsqueda solo contiene una palabra, no hay otras palabras en las que puedan basarse los resultados irrelevantes.
Los cinco primeros resultados podían parecer normales
Los resultados irrelevantes no siempre aparecían desde el principio. Una página podía empezar con resultados relevantes y cambiar a mitad de la lista.
En nuestra muestra, los resultados irrelevantes empezaban entre las posiciones 6 y 8 en el 3,5 % de los conjuntos de resultados afectados. En el 96,5 % de los casos restantes, el cambio se producía más abajo (en la posición 9 o inferior).
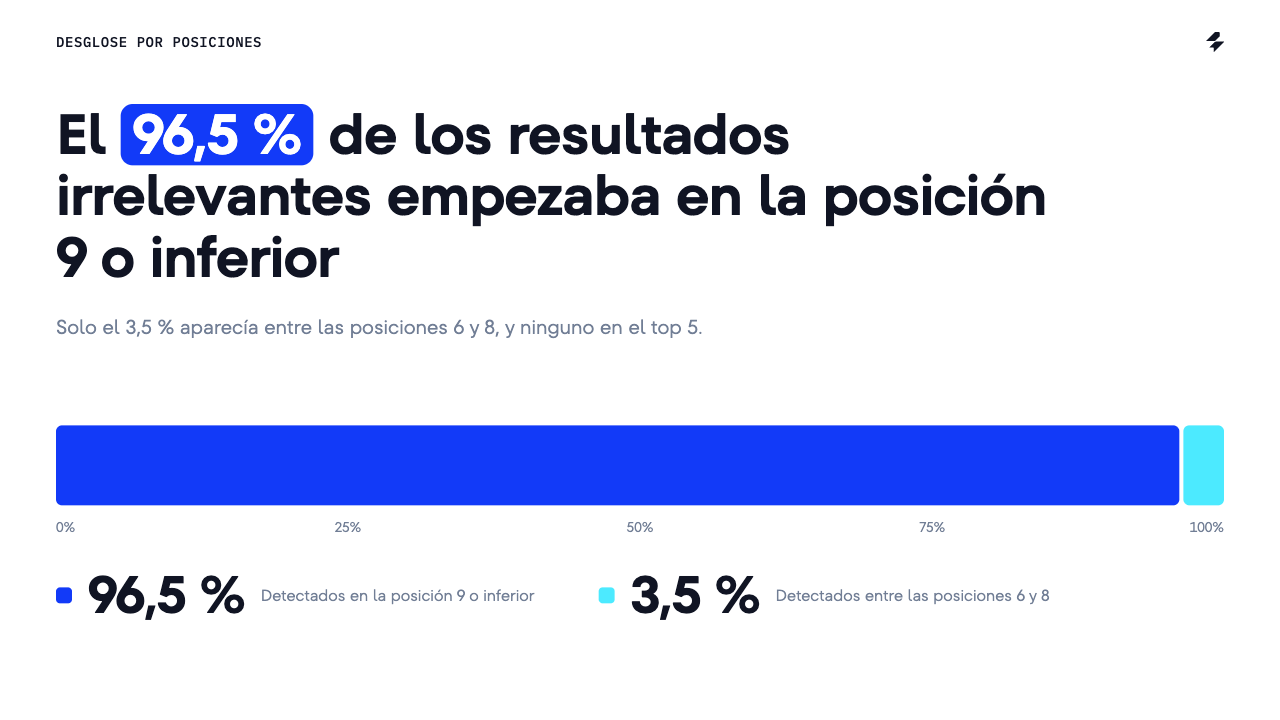
Un vistazo rápido a los primeros resultados podía dar la impresión de que todo iba bien. Sin embargo, al bajar un poco más, los resultados podían tener poco que ver con la búsqueda original.
Por eso, si un sitio web suele posicionarse en esa parte de la lista, los resultados irrelevantes podían desplazarlo de las posiciones que ocupaba en los datos recopilados. La herramienta podía indicar entonces que el sitio había desaparecido o perdido posiciones, aunque eso no significara necesariamente que su posicionamiento real hubiera cambiado para quienes realizan búsquedas en Google.
Facebook apareció en el 45,2 % de los resultados irrelevantes de Google, seguido de Reddit e Instagram
Los resultados irrelevantes procedían a menudo de grandes plataformas. Facebook apareció en el 45,2 % de los casos analizados, Reddit en el 41,3 % e Instagram en el 31,6 %.
Sin embargo, no solo aparecían redes sociales. También encontramos sitios de noticias, diccionarios, tiendas de aplicaciones y bases de datos científicas.
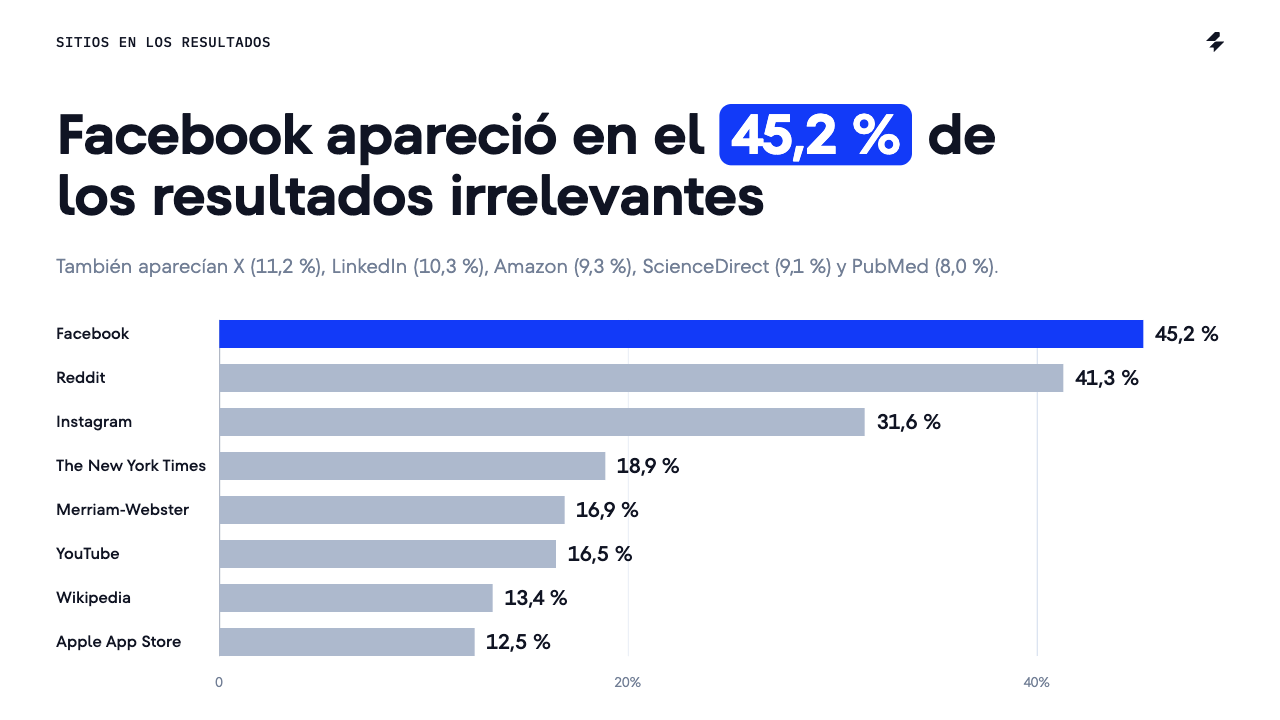
Merriam-Webster es un ejemplo especialmente revelador. Apareció aproximadamente en uno de cada seis casos analizados, con definiciones de diccionario de la palabra en la que se centraban los resultados irrelevantes. La definición podía ser correcta y, aun así, tener poco que ver con lo que la persona buscaba.
Lo mismo ocurría con el resto de los sitios de la lista. Una entrada de diccionario, una publicación de Facebook o una noticia pueden parecer fiables por sí solas. Para detectar el problema, hay que comprobar si responden a la búsqueda completa.
Qué hacer si una posición parece incorrecta
Si una posición te parece inesperada, empieza por volver a comprobarla en tu herramienta de seguimiento de posiciones. Antes de dar por confirmada una pérdida de posiciones, dedica un momento a revisar la evolución reciente de esa palabra clave.
- Fíjate en el patrón. ¿Ha caído una sola palabra clave o han cambiado varias a la vez? No te limites al día anterior: revisa varios días para ver si la tendencia se mantiene.
- Contrasta con otros datos. Busca cambios en las impresiones y los clics de Google Search Console para la consulta y la página correspondientes. Ten en cuenta las diferencias de fechas, país y dispositivo. Una sola comparación no basta para determinar la causa.
Si estás preparando un informe para un cliente, verifica cualquier caída aislada y repentina antes de presentarla como una pérdida de visibilidad. Al mismo tiempo, no des por hecho que todo cambio inesperado es un problema de datos: un descenso sostenido y respaldado por otras señales merece un análisis SEO más a fondo.
Metodología del estudio
Analizamos 10 000 palabras clave de Google en EE. UU. para búsquedas desde escritorio y registramos hasta 50 resultados orgánicos por palabra clave, junto con sus posiciones, URLs y dominios. Los datos abarcan el periodo del 14 al 24 de septiembre, con cuatro consultas adicionales los días 14 y 15 de octubre. El periodo de prueba del 17 al 24 de septiembre incluyó 80 000 casos (combinaciones de palabra clave y día).
Revisamos los resultados en tres fases:
- Creamos una referencia para cada palabra clave. Para cada palabra clave, recopilamos todos los resultados que Google devolvió en siete consultas de referencia realizadas fuera del periodo afectado: tres en septiembre y cuatro en octubre. En conjunto, estos resultados nos permitieron establecer qué páginas aparecían habitualmente para cada palabra clave. Después comparamos los resultados de cada día de prueba con esta referencia en dos niveles. Primero, por dominio: si un sitio no había aparecido nunca para esa palabra clave en las consultas de referencia, lo considerábamos desconocido. Sin embargo, esto no era suficiente, porque muchas páginas irrelevantes pertenecían a dominios que aparecen en búsquedas de todo tipo, como Facebook, Reddit, YouTube o The New York Times. Una comprobación basada únicamente en el dominio habría considerado normales esos resultados. Por eso, cuando un dominio ya figuraba en la referencia, comprobábamos también si la página concreta había aparecido anteriormente para esa palabra clave. Por ejemplo, una publicación de Facebook sobre Deadpool («the fans got Deadpool off the ground so many years ago», es decir, «los fans sacaron adelante a Deadpool hace tantos años») apareció para la búsqueda «how many calories do Americans eat on Thanksgiving» (cuántas calorías consumen los estadounidenses en Acción de Gracias). El dominio facebook.com superaba la comprobación por dominio, pero la publicación no superaba la comprobación por página: solo coincidía con la búsqueda en la palabra «many».
- Separamos los cambios sospechosos de los movimientos normales de posiciones. Que una página no apareciera en la referencia no significaba necesariamente que fuera irrelevante. Las posiciones fluctúan, aparecen páginas nuevas y las posiciones más bajas suelen variar más que las primeras. Por eso, calculamos en cada caso la proporción de resultados desconocidos, tanto por dominio como por página, y lo marcamos cuando esta proporción alcanzaba el 50 %. También revisamos los casos que no llegaban a ese umbral para detectar secuencias más cortas de resultados irrelevantes.
- Validamos los resultados. Seleccionamos 750 casos con resultados desconocidos y otros 150 correspondientes a días de referencia, que utilizamos como grupo de control. Revisamos los títulos y las descripciones de todos ellos. Dos revisores de IA evaluaron cada caso de forma independiente, sin conocer la fecha ni el resultado del algoritmo. Cuando sus evaluaciones no coincidían, revisamos manualmente 40 casos y utilizamos esa revisión para establecer una regla de desempate. Ninguno de los casos del grupo de control se consideró irrelevante. Las cifras diarias de este artículo están ponderadas según los resultados de estas revisiones. De este modo, tenemos en cuenta tanto los falsos positivos entre los casos marcados como los resultados irrelevantes que el algoritmo no llegó a detectar.
Aviso: Los resultados se refieren únicamente a esta muestra. La configuración utilizada para recopilar las consultas de octubre fue distinta de la de septiembre. Solo analizamos los resultados orgánicos; no incluimos AI Overviews, anuncios ni otras funciones de búsqueda. Los datos no permiten determinar la intención de Google, cuánto duró el problema a lo largo de un mismo día ni qué resultados veían las personas que realizaban búsquedas directamente. SE Ranking no está afiliada a Google.