Canonical Tag: Der komplette Guide für SEO
Ein Canonical Tag (<link rel=”canonical” href=”…”>) ist ein HTML-Element im <head> einer Seite. Damit sagst du Suchmaschinen, welche URL aus einer Gruppe identischer oder sehr ähnlicher Seiten die Hauptversion ist. Google wertet das Tag als starkes Signal, aber nicht als verbindliche Anweisung, und gleicht es mit Weiterleitungen, internen Links, HTTPS und der Sitemap ab. In der Praxis bekommt deshalb jede indexierbare Seite einen selbstreferenzierenden Canonical. Filter-, Sortier- und Tracking-URLs verweisen per Canonical auf die Hauptversion.
Das Tag selbst ist in einer Minute gesetzt. Schwierig wird es dort, wo Templates, Plugins, Weiterleitungen oder hreflang dem Canonical widersprechen und Google deshalb eine andere URL wählt, als du angegeben hast. Dieser Guide zeigt dir, wie Google die kanonische URL bestimmt, in welchen Fällen du den Canonical brauchst, welche Fehler am häufigsten vorkommen und wie du in der Google Search Console prüfst, ob Google deinem Hinweis folgt.
-
Ein Canonical Tag nennt Suchmaschinen die bevorzugte URL, wenn derselbe Inhalt unter mehreren Adressen erreichbar ist.
-
Du setzt ihn als Link-Element rel=”canonical” im Head-Bereich der Seite, bei PDFs im HTTP-Header. Die XML-Sitemap zählt nur als schwaches Zusatzsignal.
-
Google behandelt den Canonical als starken Hinweis und wägt ihn gegen Weiterleitungen, HTTPS, Sitemap und interne Links ab.
-
Jede indexierbare Seite braucht einen selbstreferenzierenden Canonical mit absoluter URL, Duplikate verweisen auf die Hauptversion.
-
Die häufigsten Fehler sind relative URLs, Ziele mit 404 oder Weiterleitung, mehrere Canonicals pro Seite und Widersprüche zu noindex oder hreflang.
-
Ob Google deinem Canonical folgt, zeigen dir die URL-Prüfung der Search Console sowie der Rank-Tracker und das Website-Audit von SE Ranking.
-
Duplicate Content führt nicht zu einer Abstrafung. Das Risiko besteht darin, dass die falsche URL rankt.
Was ist ein Canonical Tag im SEO?
Mit einem Canonical Tag nennst du Suchmaschinen die bevorzugte URL, wenn derselbe oder fast derselbe Inhalt unter mehreren Adressen erreichbar ist. Google, Microsoft und Yahoo haben das Element im Februar 2009 gemeinsam eingeführt, seit 2012 ist es als RFC 6596 standardisiert.
Gebraucht wird das Tag häufiger, als viele denken. Eine Produktseite ist mit und ohne Parameter erreichbar, ein Artikel steckt in zwei Kategoriepfaden, die Startseite antwortet mit und ohne www. Ohne Canonical entscheidet Google allein, welche Variante in den Suchergebnissen erscheint und auf welche URL sich Links und andere Signale konzentrieren.
Was ist eine kanonische URL?
Im Alltag werden Canonical Tag, Canonical Link und kanonische URL oft gleichgesetzt, genau genommen beschreiben sie aber zwei verschiedene Dinge. Canonical Tag und Canonical Link meinen das HTML-Element <link rel=”canonical”>, also deinen Hinweis an die Suchmaschine. Die kanonische URL ist die Adresse, die Google am Ende als Hauptversion auswählt. Google beschreibt sie als die URL, die aus einer Gruppe doppelter Seiten am repräsentativsten ist.
Im Idealfall stimmen Hinweis und Auswahl überein. In der Search Console siehst du beide getrennt, als „vom Nutzer angegebene“ und als „von Google ausgewählte“ kanonische URL. Weichen sie voneinander ab, hat Google deinen Canonical überstimmt.
Eine Abstrafung wegen doppelter Inhalte musst du dabei nicht befürchten. Laut Google ist Duplicate Content auf einer Website normal und kein Verstoß gegen die Spamrichtlinien. Das eigentliche Risiko liegt woanders. Google zeigt womöglich die falsche URL in den Suchergebnissen, und Links sowie andere Signale verteilen sich auf mehrere Versionen statt auf eine. Wie du doppelte Inhalte findest und behebst, zeigt unser eigener Guide.
Wie du die kanonische URL festlegst
Google nennt in seiner Dokumentation mehrere Wege, eine kanonische URL anzugeben. Sie unterscheiden sich vor allem darin, wie stark Google sie gewichtet. Weiterleitungen und rel=”canonical” gelten als starke Signale, ein Eintrag in der XML-Sitemap als schwaches.
Link-Element im <head>
Am weitesten verbreitet ist das Link-Element rel=”canonical” im <head>-Bereich der Seite. Auf jeder Duplikat-URL steht dann derselbe Verweis auf die Hauptversion:
<head>

   <link rel="canonical" href="https://www.beispiel.com/bevorzugte-seite.html">

</head>
Setze den Link rel canonical ausschließlich in den <head>, denn im <body> ignoriert Google ihn. Gib die URL außerdem absolut an, also inklusive Protokoll und Domain. Eine relative Angabe wie beispiel.com/seite liest Google als Pfad unterhalb der aktuellen URL und landet auf einer falschen Adresse.
Canonical im HTTP-Header
Dateien ohne HTML-Code, etwa PDFs, haben keinen <head>. Den Canonical übergibst du dort im HTTP-Antwortheader:
Link: <https://www.beispiel.com/bevorzugte-seite.html>; rel="canonical"
In der Praxis ist das eine Nischenmethode. Laut Web Almanac 2025 übergeben nur 0,6 % der Desktop-Seiten ihren Canonical per HTTP-Header, während 64,4 % ihn direkt im HTML setzen.
XML-Sitemap
Mit jeder URL in deiner sitemap.xml schlägst du Google diese Adresse als kanonisch vor. Bei großen Websites mit Tausenden Seiten ist das eine hilfreiche Ergänzung, Google stuft es aber als schwaches Signal ein. Nimm deshalb nur kanonische URLs in die Sitemap auf und verlass dich nie allein auf sie.
Selbstreferenzierender Canonical
Auch die Hauptversion selbst sollte einen Canonical enthalten, der auf die eigene URL zeigt. Google rät seit Jahren dazu, seit Juli 2026 steht die Empfehlung auch ausdrücklich in der offiziellen Dokumentation. Hängt jemand zum Beispiel ?utm_source=newsletter an deine URL, verweist der Canonical weiterhin auf die Version ohne Parameter. Die meisten CMS und SEO-Plugins setzen ihn automatisch. Prüfe im Quelltext trotzdem, ob er vorhanden ist und nur einmal vorkommt.
Wie Google die kanonische URL auswählt
Google fasst identische oder sehr ähnliche Seiten zu einer Duplikatgruppe zusammen und wählt daraus eine URL als kanonisch. Laut Allan Scott aus Googles Duplikat-Team wertet Google dafür rund 40 verschiedene Signale aus. Widersprechen sich starke Signale wie Canonical und Weiterleitung, greift das System auf schwächere zurück. Die wichtigsten Faktoren nennt Google selbst:
- Weiterleitungen: Eine 301-Weiterleitung ist ein starkes Signal dafür, dass das Ziel kanonisch werden soll.
- rel=”canonical”: Im HTML oder im HTTP-Header gesetzt, gilt der Canonical ebenfalls als starkes Signal.
- HTTPS statt HTTP: Google bevorzugt die HTTPS-Version, solange sie fehlerfrei funktioniert. Das gilt nicht, wenn das SSL-Zertifikat ungültig ist, die HTTPS-Seite unsichere Ressourcen lädt, von HTTPS auf HTTP weitergeleitet wird oder ihr Canonical auf die HTTP-Version zeigt.
- XML-Sitemap: Ein Eintrag in der Sitemap zählt als schwaches Signal.
- Interne und externe Links: Verlinkst du intern konsequent eine andere Variante als die im Canonical angegebene, widersprichst du deinem eigenen Hinweis.
Betreibst du noch eine separate mobile Version, etwa m.beispiel.com, sollte die mobile Seite per Canonical auf die Desktop-URL verweisen und die Desktop-Seite per rel=”alternate” auf die mobile. Seit der Umstellung auf Mobile-First-Indexing ist ein responsives Design mit nur einer URL die einfachere Lösung.
Meist übernimmt Google den angegebenen Canonical. Widersprechen sich die Signale oder hält Google eine andere Seite für nützlicher, wählt es selbst. Das kann sogar durch Bot-Schutz passieren. Zeigt eine Firewall oder ein CDN dem Googlebot statt deiner Seite eine „Bist du ein Mensch?“-Abfrage, sieht Google womöglich nur diese Zwischenseite, stuft sie als Duplikat ähnlicher Seiten anderer Websites ein und wählt eine fremde URL als kanonisch.
Warum sind Canonical Tags für SEO wichtig?
Canonical Tags bündeln Linksignale, die sich sonst auf mehrere URL-Varianten verteilen würden, und sorgen dafür, dass die gewünschte Version in den Suchergebnissen erscheint. Entsprechend verbreitet ist das Tag. Laut Web Almanac 2025 setzen 68 % der Desktop-Seiten und 67 % der mobilen Seiten einen Canonical, ein Jahr zuvor waren es jeweils 65 %.
Crawl-Budget sparst du damit kaum. Google crawlt kanonisierte URLs weiterhin, nur seltener. Wer bei großen Shops das Crawling spürbar reduzieren will, braucht zusätzlich eine durchdachte interne Verlinkung und eine konsistente Strategie für URL-Parameter.
Auch bei Keyword-Kannibalisierung hilft der Canonical. Konkurrieren zwei fast gleiche Seiten um dieselbe Suchanfrage, legst du damit fest, welche von beiden ranken soll.
Daraus ergibt sich eine einfache Regel. Jede indexierbare Seite bekommt einen selbstreferenzierenden Canonical, jedes Duplikat einen Canonical auf die Hauptversion. Damit gehört der Canonical zu den Grundregeln der technischen OnPage-SEO.
Wann solltest du Canonical Tags einsetzen?
Die folgenden Fälle decken den Großteil dessen ab, was dir in Shops, Blogs und Unternehmensseiten begegnet.
Facettierte Navigation
Filter und Sortierungen verbessern die Nutzerführung, erzeugen aber schnell Hunderte URL-Varianten für denselben Inhalt. Filtert jemand in einem Shop schwarze Jeans in Größe 10, könnte die URL so aussehen:
https://example.com/women-jeans/black/size=10
Wählt die Person zuerst die Größe und dann die Farbe, entsteht für dieselben Produkte eine zweite Adresse:
https://example.com/women-jeans/size=10/black
Bei Sortieroptionen passiert dasselbe, wie die Laptop-Kategorie auf eBay zeigt. Die Kategorieseite verweist per Canonical auf sich selbst:
<link rel="canonical"
href="https://www.ebay.com/b/Workstation-Laptops-Netbooks/175672/bn_7116632031" />

Wechselst du den Ansichtstyp auf Liste, ändert sich die URL zu https://www.ebay.com/b/Workstation-Laptops-Netbooks/175672/bn_7116632031?rt=nc&_dmd=1. Die URL-Parameter am Ende steuern Sortierung und Darstellung. Für eine Suchmaschine ist jede Variante mit neuem Parameter eine eigene URL.

Manche SEOs sperren solche Varianten per noindex oder robots.txt. Der Canonical ist in den meisten Fällen die bessere Wahl, und zwar aus drei Gründen:
- Die Linkkraft der Varianten wandert zur Hauptversion. Mit noindex oder robots.txt geht sie verloren.
- Der Crawler kann die Varianten weiterhin aufrufen und den Links darauf folgen.
- Google rät ausdrücklich davon ab, robots.txt zur Kanonisierung einzusetzen, denn blockierte URLs kann der Crawler nicht mit der Hauptversion vergleichen.
Gleiche Artikel in verschiedenen Kategorien
Viele Shops führen ein Produkt in mehreren Kategorien. Ein Weihnachtspullover für Damen steckt zum Beispiel in der Damenbekleidung und in der Winterkollektion und ist dadurch unter zwei URLs erreichbar:
https://www.example.com/women-clothing/your-product/
https://www.example.com/winter-collection/your-product/
Für Google sind das zwei Seiten mit identischem Inhalt. Per Canonical legst du fest, welche Produktseite die offizielle ist.
Noch besser ist es, die doppelte URL gar nicht erst entstehen zu lassen. Verlinken beide Kategorien direkt auf eine einzige Produkt-URL, braucht Google keinen Hinweis, und du sparst dir die Pflege von Canonicals für jedes Produkt.
UTM-Tags und Tracking-Parameter
UTM-Tags und Tracking-Parameter erzeugen ebenfalls neue URLs. Aus https://site.com/page/ wird nach einem Klick auf Facebook zum Beispiel https://site.com/page/?fbclid=IwAR3cnDV4ERw24pQNVLTFlwKzchPDA1. Der selbstreferenzierende Canonical auf der Hauptversion ohne Parameter fängt solche Varianten automatisch ab.
Paginierung
Für paginierte Seiten gibt es zwei gängige Ansätze, je nachdem, ob die Folgeseiten in den Index sollen.
Beim ersten Ansatz erhält jede paginierte Seite einen selbstreferenzierenden Canonical, wie es Google empfiehlt. Seite 2 verweist also auf Seite 2:
https://site.com/catalog/page/2/ contains <link rel="canonical" href="https://site.com/catalog/page/2/" />.
Crawler erreichen so alle Seiten der Serie, und die Produkte ab Seite 2 bleiben auffindbar. Die früher übliche Auszeichnung mit rel=”next” und rel=”prev” nutzt Google seit 2019 nicht mehr als Signal.
Sollen die Folgeseiten nicht indexiert werden, ist der Canonical das falsche Werkzeug. Verwende stattdessen das Meta-Tag <meta name=”robots” content=”noindex, follow” />. Suchmaschinen crawlen die Seiten dann und folgen den Links, nehmen sie aber nicht in den Index auf.
Was du auf keinen Fall tun solltest, ist alle Folgeseiten per Canonical auf Seite 1 zeigen zu lassen. Mehr dazu findest du in unserem Guide zur Paginierung im SEO.
Druckversionen, PDFs und syndizierte Inhalte
Bietest du denselben Inhalt als Druckversion oder PDF an, entsteht ebenfalls Duplicate Content. Für HTML-Druckansichten setzt du den Canonical wie gewohnt im <head>, für PDFs über den HTTP-Header.
Dasselbe Prinzip gilt über Domaingrenzen hinweg. Übernimmt ein Partner oder ein Fachportal deinen Artikel, bitte um einen Canonical auf deine Original-URL. So bleibt dein Artikel die Version, die rankt.
Häufige Canonical-Fehler und wie du sie vermeidest
Ein Canonical Tag ist schnell gesetzt und genauso schnell falsch gesetzt. Die meisten Fehler entstehen nicht beim Schreiben des Tags, sondern im Zusammenspiel mit Templates, Plugins, Weiterleitungen und anderen Signalen. Die Tabelle zeigt die häufigsten Probleme, was sie auslösen und wie du sie behebst.
Was passiert
Google liest die Angabe als Pfad unterhalb der aktuellen URL und landet auf einer falschen Adresse
So behebst du ihn
Immer die absolute URL inklusive https:// angeben
Was passiert
Google ignoriert den Hinweis und wählt selbst eine kanonische Version
So behebst du ihn
Die Ziel-URL muss mit Status 200 erreichbar und indexierbar sein
Was passiert
Bei widersprüchlichen Angaben ignoriert Google sie in der Regel alle
So behebst du ihn
Nur ein Canonical pro Seite, doppelte Ausgaben von Theme und SEO-Plugin (z. B. in WordPress) prüfen
Was passiert
Im Body-Bereich ignoriert Google das Tag, per JavaScript sieht Google es erst nach dem Rendern
So behebst du ihn
Tag direkt im Head-Bereich des HTML ausliefern und das gerenderte HTML prüfen
Was passiert
Inhalte ab Seite 2 fallen aus dem Index
So behebst du ihn
Jede paginierte Seite mit selbstreferenzierendem Canonical auszeichnen
Was passiert
Widersprüchliche Signale, denn der Canonical verweist auf eine andere URL, noindex will gar nichts im Index
So behebst du ihn
Für Duplikate den Canonical nutzen, noindex nur für Seiten, die nicht in den Index sollen
Was passiert
Google kann das Ziel nicht crawlen und die Seiten nicht vergleichen
So behebst du ihn
Kanonische URLs nie per robots.txt sperren
Was passiert
Die Sprachvariante gilt als Duplikat und fällt aus dem Index
So behebst du ihn
Jede Sprachversion verweist per Canonical auf sich selbst
Was passiert
Google muss mehrere Hinweise auflösen, das Signal wird unzuverlässig
So behebst du ihn
Alle Duplikate direkt auf die finale URL verweisen
Was passiert
Google bevorzugt HTTPS und kann den Hinweis überstimmen
So behebst du ihn
Protokoll und Hostnamen (mit oder ohne www) exakt übernehmen
Google liest die Angabe als Pfad unterhalb der aktuellen URL und landet auf einer falschen Adresse
Immer die absolute URL inklusive https:// angeben
Google ignoriert den Hinweis und wählt selbst eine kanonische Version
Die Ziel-URL muss mit Status 200 erreichbar und indexierbar sein
Bei widersprüchlichen Angaben ignoriert Google sie in der Regel alle
Nur ein Canonical pro Seite, doppelte Ausgaben von Theme und SEO-Plugin (z. B. in WordPress) prüfen
Im Body-Bereich ignoriert Google das Tag, per JavaScript sieht Google es erst nach dem Rendern
Tag direkt im Head-Bereich des HTML ausliefern und das gerenderte HTML prüfen
Inhalte ab Seite 2 fallen aus dem Index
Jede paginierte Seite mit selbstreferenzierendem Canonical auszeichnen
Widersprüchliche Signale, denn der Canonical verweist auf eine andere URL, noindex will gar nichts im Index
Für Duplikate den Canonical nutzen, noindex nur für Seiten, die nicht in den Index sollen
Google kann das Ziel nicht crawlen und die Seiten nicht vergleichen
Kanonische URLs nie per robots.txt sperren
Die Sprachvariante gilt als Duplikat und fällt aus dem Index
Jede Sprachversion verweist per Canonical auf sich selbst
Google muss mehrere Hinweise auflösen, das Signal wird unzuverlässig
Alle Duplikate direkt auf die finale URL verweisen
Google bevorzugt HTTPS und kann den Hinweis überstimmen
Protokoll und Hostnamen (mit oder ohne www) exakt übernehmen
Der JavaScript-Fall betrifft mehr Seiten, als man vermuten würde. Laut Web Almanac 2025 enthalten 64,4 % der Desktop-Seiten den Canonical bereits im ausgelieferten HTML, nach dem Rendern sind es 66,0 %. Bei rund 1,6 % der Seiten taucht er also erst auf, wenn JavaScript ausgeführt wurde. Wie die Verweise zwischen Sprachversionen korrekt aussehen, erklärt unser Guide zu hreflang-Tags.
Canonical Tag, 301-Weiterleitung oder noindex?
Canonical Tag, 301-Weiterleitung und noindex lösen verwandte, aber unterschiedliche Probleme. Die Weiterleitung schickt Nutzer und Crawler dauerhaft auf eine neue URL. Der Canonical lässt beide Versionen erreichbar und bündelt nur die Signale. Mit noindex nimmst du eine Seite ganz aus dem Index, ohne ihre Signale an eine andere URL weiterzugeben.
Duplikat-URL für Nutzer erreichbar?
Nein
Signalstärke laut Google
Starkes Signal
Wann einsetzen
Die alte URL wird nicht mehr gebraucht, etwa nach Relaunch, Migration oder dem Zusammenlegen von Artikeln
Duplikat-URL für Nutzer erreichbar?
Ja
Signalstärke laut Google
Starkes Signal
Wann einsetzen
Das Duplikat muss erreichbar bleiben, etwa bei Filtern, Sortierungen, Tracking-Parametern oder Druckversionen
Duplikat-URL für Nutzer erreichbar?
Ja
Signalstärke laut Google
Schwaches Signal
Wann einsetzen
Ergänzend zu Canonical oder Weiterleitung, nie als einzige Methode
Duplikat-URL für Nutzer erreichbar?
Ja
Signalstärke laut Google
Kein Signal zur Kanonisierung
Wann einsetzen
Die Seite soll überhaupt nicht in den Index, etwa interne Suche oder Warenkorb
Duplikat-URL für Nutzer erreichbar?
Ja
Signalstärke laut Google
Für Kanonisierung ungeeignet
Wann einsetzen
Crawling steuern, nicht Indexierung
Nein
Starkes Signal
Die alte URL wird nicht mehr gebraucht, etwa nach Relaunch, Migration oder dem Zusammenlegen von Artikeln
Ja
Starkes Signal
Das Duplikat muss erreichbar bleiben, etwa bei Filtern, Sortierungen, Tracking-Parametern oder Druckversionen
Ja
Schwaches Signal
Ergänzend zu Canonical oder Weiterleitung, nie als einzige Methode
Ja
Kein Signal zur Kanonisierung
Die Seite soll überhaupt nicht in den Index, etwa interne Suche oder Warenkorb
Ja
Für Kanonisierung ungeeignet
Crawling steuern, nicht Indexierung
Die Signalstärken stammen aus Googles Dokumentation zur Kanonisierung. Ziehst du eine Website um, sind Weiterleitungen das Mittel der Wahl. Wie du dabei vorgehst, zeigt unser Guide zur Website-Migration.
Canonical-Meldungen in der Google Search Console richtig deuten
Ob Google deinen Canonical übernommen hat, erfährst du in der Google Search Console. Hast du die Search Console für deine Website eingerichtet, helfen dir dort zwei Berichte weiter.
Für einzelne Seiten nutzt du die URL-Prüfung. Sie zeigt dir die vom Nutzer angegebene und die von Google ausgewählte kanonische URL direkt nebeneinander. Weichen beide ab, ist das der erste Hinweis auf widersprüchliche Signale.

Für die ganze Website öffnest du den Bericht „Seitenindexierung“. Er listet alle nicht indexierten Seiten mit dem jeweiligen Grund. Drei Meldungen tauchen dabei besonders oft auf, und nur eine davon ist ein echtes Problem:
- „Alternative Seite mit richtigem kanonischen Tag“ bedeutet, dass alles in Ordnung ist. Die URL ist ein Duplikat, verweist korrekt auf die Hauptversion, und Google hat das übernommen.
- „Duplikat – vom Nutzer nicht als kanonisch festgelegt“ heißt, dass Google Duplikate gefunden hat, aber keinen Canonical. Setze ihn auf die gewünschte Hauptversion.
- „Duplikat – Google hat eine andere Seite als der Nutzer als kanonische Seite bestimmt“ zeigt, dass sich deine Signale widersprechen. Prüfe interne Links, Weiterleitungen, Sitemap und hreflang auf die gewünschte URL.

Auch der Leistungsbericht liefert Hinweise. Erhalten nicht kanonische URLs dort Impressionen, zeigt Google sie in den Suchergebnissen, und dein Canonical wird vermutlich ignoriert. Das passiert selbst bei korrekt gesetzten Tags, etwa wenn die nicht kanonische Variante mehr interne Links oder Backlinks bekommt.
Nach einer Korrektur brauchst du Geduld. Laut Google kann eine Seite bis zu zwei Wochen in der Duplikatgruppe bleiben, auch wenn das Problem bereits behoben ist. Wie du die übrigen Meldungen behebst, zeigt unser Guide zu Indexierungsproblemen in der Search Console.
Canonical-Probleme mit SE Ranking finden
Im Rank-Tracker von SE Ranking siehst du für jedes Keyword, welche URL tatsächlich rankt. Hinterlegst du eine Ziel-URL, markiert das Tool Abweichungen. Das ist oft der schnellste Hinweis darauf, dass Google eine andere Version als kanonisch gewählt hat. Im Bericht „Details“ fährst du dazu mit der Maus über die URL neben dem Keyword.
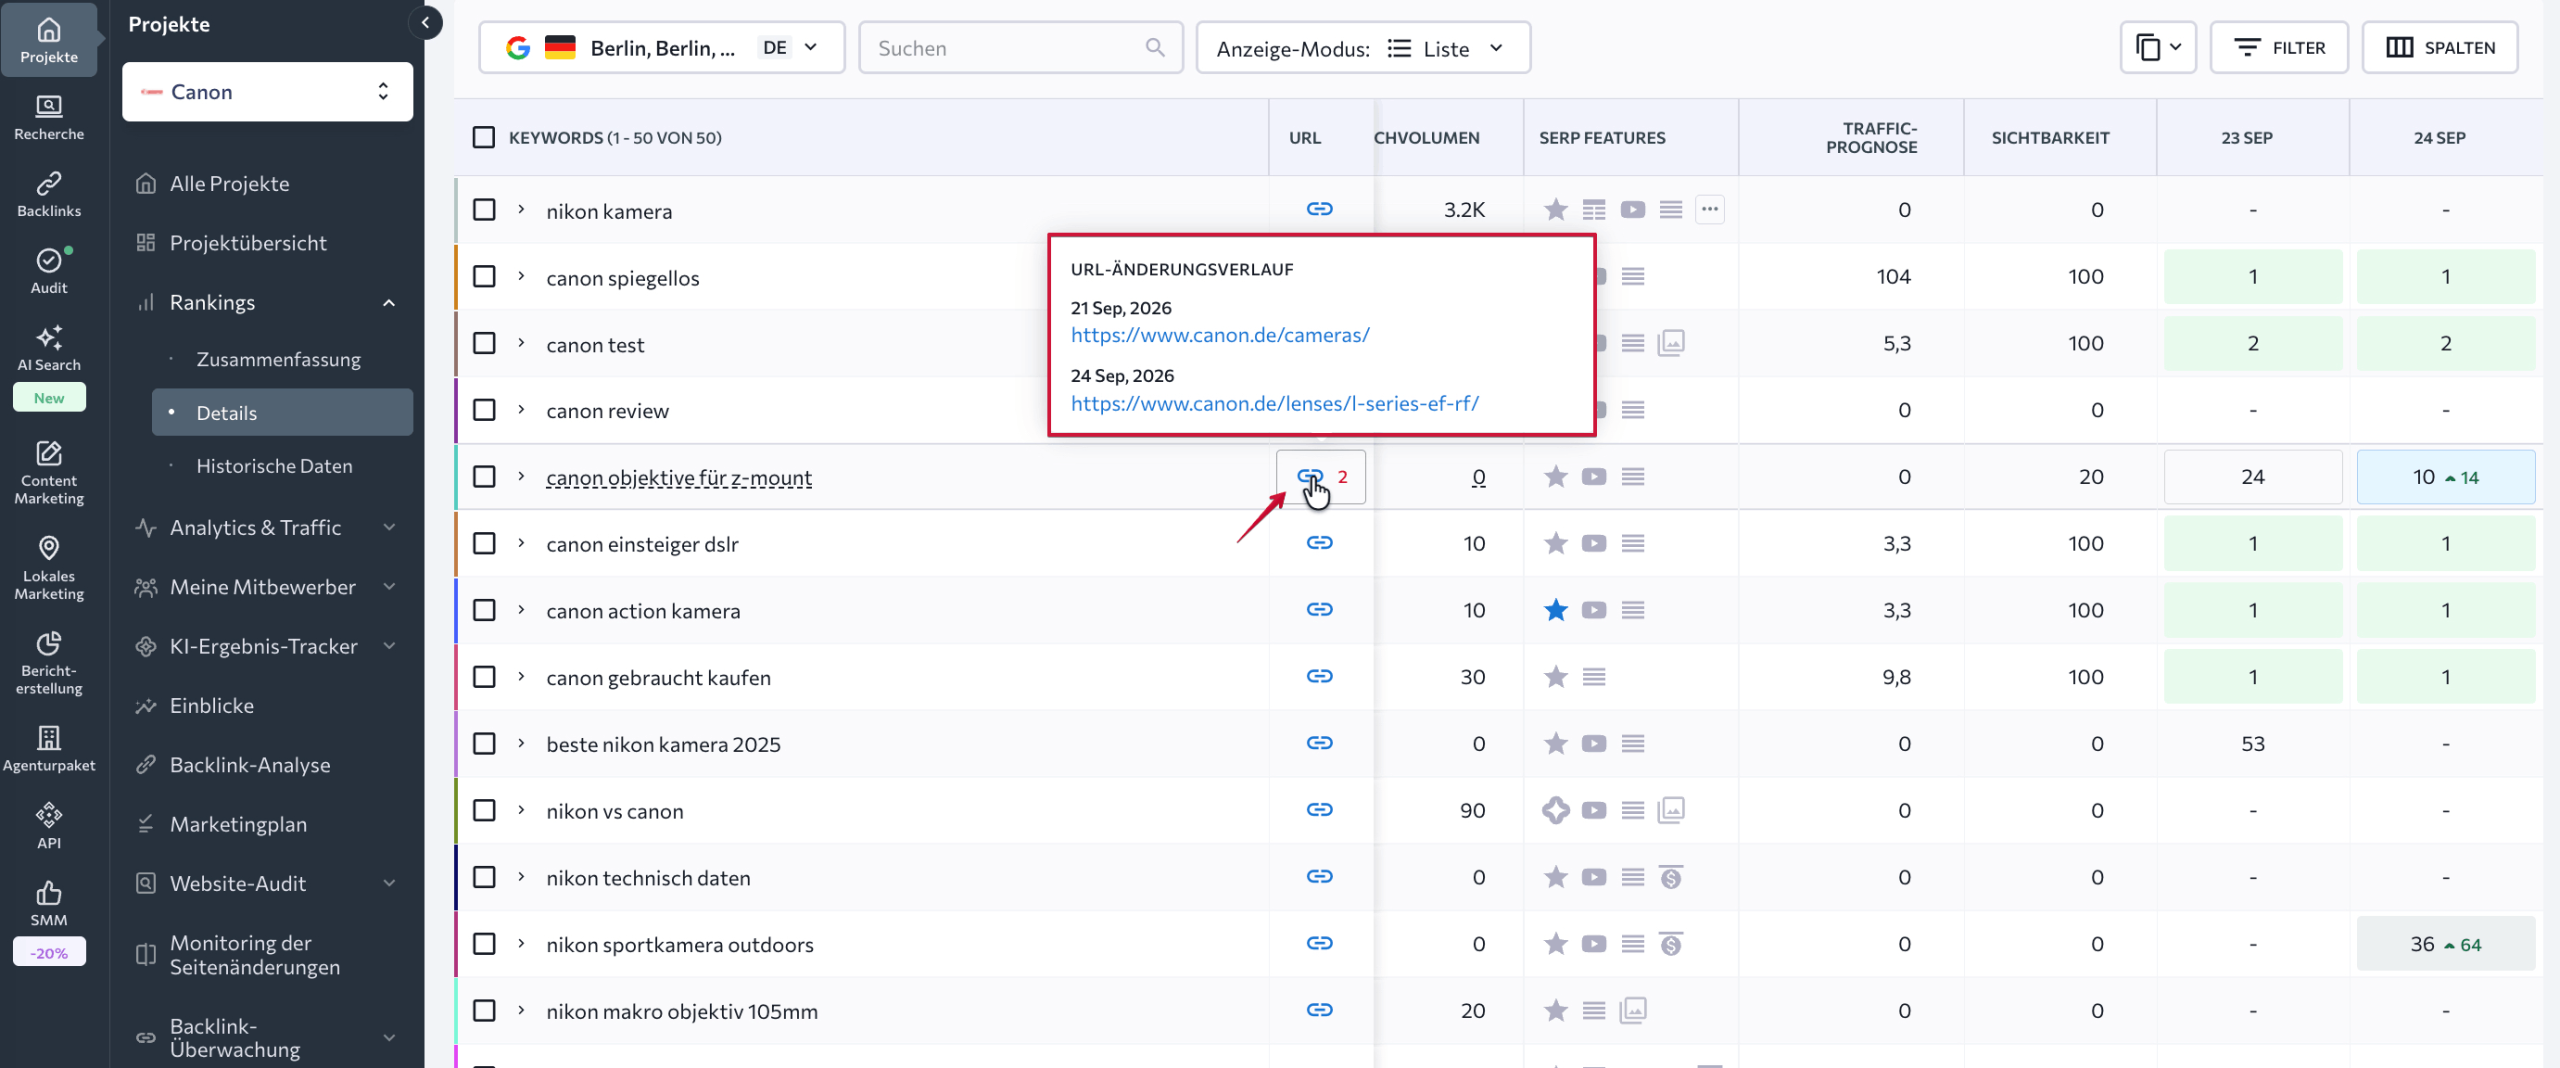
- Die Zahl rechts gibt an, wie viele Seiten deiner Website für das jeweilige Keyword konkurrieren.
- Ein blaues Symbol bedeutet, dass die URL für das Keyword in den Suchergebnissen gefunden wurde.
- Ein graues Symbol bedeutet, dass die URL für das Keyword nicht gefunden wurde.
- Ein rotes Symbol markiert eine Abweichung zwischen der tatsächlich rankenden URL und der Ziel-URL, die du für das Keyword festgelegt hast.
Für die ganze Website prüft das Website-Audit von SE Ranking die Indexierbarkeit deiner Seiten und führt Canonical-Probleme als eigene Prüfpunkte auf: Canonical-URLs mit 3xx-, 4xx- oder 5xx-Status, Canonical-Ketten, mehrere Canonical Tags auf einer Seite, Canonicals von HTTPS auf HTTP, nicht kanonische Seiten in der XML-Sitemap und hreflang-Verweise auf nicht kanonische Seiten. Alle betroffenen Seiten exportierst du als Liste und gibst sie direkt an die Entwicklung weiter. Nach dem Fix startest du einen neuen Crawl und siehst im Crawl-Vergleich, ob die Meldungen verschwunden sind.
Canonical-Prüfung per MCP automatisieren
Wer mehrere Websites betreut, muss die Audit-Ergebnisse nicht jede Woche von Hand durchklicken. Über den MCP-Server von SE Ranking greift ein KI-Assistent wie Claude direkt auf deine Audit-Daten zu und erledigt die Routine im Chat. Ein typischer Ablauf sieht so aus:
- Der Assistent startet für ein bestehendes Audit einen neuen Crawl.
- Aus dem fertigen Bericht filtert er alle Canonical-Prüfpunkte heraus und zählt die betroffenen Seiten.
- Für jedes Problem ruft er die Liste der URLs ab.
- Daraus formuliert er ein Ticket für die Entwicklung, sortiert nach Fehlertyp.
- Nach dem Fix stößt er erneut einen Crawl an und vergleicht die Zahlen mit dem vorherigen Stand.
Dafür reicht eine Anweisung wie diese:
Prüfe im letzten Website-Audit meiner Domain alle Canonical-Fehler. Liste die betroffenen URLs je Fehlertyp auf und formuliere daraus ein Ticket für unser Entwicklungsteam.
Der MCP-Zugang ist in den Tarifen Core und Growth enthalten. Welche Assistenten sich anbinden lassen und wie du sie einrichtest, zeigt unser Überblick zu den besten SEO-MCPs.
Häufige Fragen zum Canonical Tag
Was heißt canonical auf Deutsch?
„Canonical“ bedeutet „kanonisch“, also maßgeblich oder als Standard anerkannt. Ein Canonical Tag markiert entsprechend die maßgebliche Version einer Seite, wenn derselbe Inhalt unter mehreren URLs erreichbar ist.
Wer oder was ist Canonical?
Im SEO ist „Canonical“ die Kurzform für das Canonical Tag <link rel=”canonical”> beziehungsweise die kanonische URL. Nicht gemeint ist Canonical Ltd., das Unternehmen hinter der Linux-Distribution Ubuntu, das in den Suchergebnissen ebenfalls auftaucht.
Was passiert, wenn kein Canonical Tag gesetzt ist?
Ohne Canonical entscheidet Google selbst, welche Version einer Duplikatgruppe kanonisch ist. Meist funktioniert das, bei Parameter-URLs oder Varianten mit und ohne www landet aber gelegentlich die falsche Version im Index.
Wie behebe ich eine nicht kanonische URL?
Meldet die Search Console eine Seite als nicht kanonisch, prüfe zuerst, ob das beabsichtigt ist, denn bei Filter- und Parameter-URLs ist es der Normalfall. Soll die Seite selbst ranken, braucht sie einen selbstreferenzierenden Canonical, interne Links auf genau diese URL, einen Eintrag in der Sitemap und keine anderen Seiten, die per Canonical auf eine andere Version verweisen. Danach kann es bis zu zwei Wochen dauern, bis Google die Duplikatgruppe neu bewertet.
Fazit
Der Canonical Tag ist schnell eingebaut, aber nur so verlässlich wie die Signale, die ihn umgeben. Drei Regeln decken die meisten Fälle ab:
- Jede indexierbare Seite erhält einen selbstreferenzierenden Canonical mit absoluter URL.
- Filter-, Sortier-, Tracking- und Druckvarianten verweisen per Canonical auf die Hauptversion, alte URLs leitest du per 301 weiter.
- Interne Links, Sitemap, hreflang und Canonical zeigen immer auf dieselbe URL.
Ob das auf deiner Website überall zutrifft, prüfst du am schnellsten mit einem Crawl im Website-Audit von SE Ranking. Anschließend gleichst du in der Search Console ab, welche URLs Google tatsächlich als kanonisch gewählt hat.